Execute modelos de IA por conta própria, conecte-os às suas ferramentas e crie fluxos de trabalho privados sem pagar por cada token.
Ollama é o motor que você pode colocar por trás dessa estrutura.
Seu projeto de código aberto no GitHub agora tem cerca de 179.800 estrelas. Suas páginas de integração oficial incluem Claude Code, Codex, Copilot CLI, VS Code, Cline, n8n, OpenClaw, Hermes e vários outros sistemas de agentes e codificação. O projeto chegou à v0.33.2 há apenas alguns dias.
Se você usa IA regularmente, esta é uma daquelas ferramentas que acho que você deveria entender agora, antes que se torne uma daquelas coisas que todos presumem, de repente, que você já conhece.
No guia completo, levo o Ollama desde a primeira instalação até o trabalho real: executar modelos abertos localmente, escolher o modelo certo, conectar Python e n8n, criar trabalhadores de IA reutilizáveis, usar ferramentas, JSON, agentes e memória, e saber quando a IA local pode reduzir custos e manter mais trabalho privado. Se você está criando fluxos de trabalho de IA agora, esta é uma daquelas ferramentas que vale a pena entender antes que sua pilha se torne mais cara e difícil de controlar.
Primeiro, esqueça a descrição técnica
O Ollama permite que você execute modelos de IA por conta própria.
Essa é a explicação mais simples.
Em vez de abrir o ChatGPT, Claude ou outro site e enviar cada solicitação para os servidores de uma empresa, você pode baixar um modelo aberto e executá-lo em seu próprio computador.
Por exemplo:
ollama run qwen3:4bO Ollama baixa o modelo, inicia-o e te dá um chat.
Isso por si só é útil.
Mas eu não aprenderia Ollama apenas para ter outro chatbot.
O verdadeiro motivo para aprendê-lo é que outras ferramentas também podem usar esse modelo local.
Seu script Python pode usá-lo.
O n8n pode usá-lo.
Um assistente de codificação pode usá-lo.
Um agente pode usá-lo.
Um sistema de documentos privados pode usá-lo.
Uma automação pode chamá-lo 500 vezes sem que você pague por 500 requisições de API.
Essa é a parte importante.
O Ollama tornou-se muito mais do que uma ferramenta de chat local. A plataforma atual inclui APIs, embeddings, chamadas de ferramentas, loops de agentes, visão, respostas estruturadas e integrações com outras ferramentas de IA.
Instale-o e execute um modelo pequeno
Não comece comparando vinte modelos.
Não compre uma nova GPU.
Não monte um servidor de IA local complicado.
Instale o Ollama primeiro.
Ele funciona no Windows, macOS e Linux.
Download oficial:
Ollama: ollama.com/download
No Linux, você também pode usar:
curl -fsSL https://ollama.com/install.sh | sh
Verifique se funciona:
ollama --version
Em seguida, execute um modelo pequeno:
ollama run qwen3:4b
Na primeira vez, o Ollama baixa o modelo. Depois disso, o modelo permanece no seu computador.
Pergunte algo normal:
Explain this Python function in very simple language.
Ou:
Read this error and tell me:
1. what failed
2. the likely reason
3. what I should check first
Isso é o suficiente para seus primeiros dez minutos.
Comece pequeno. Assim que toda a configuração funcionar, você poderá experimentar modelos maiores.
Isso é muito melhor do que baixar um modelo enorme primeiro e descobrir que seu computador não consegue executá-lo corretamente.
Estes são os comandos que eu realmente aprenderia
Você não precisa de cinquenta comandos do Ollama.
Comece com estes:
# Run a model
ollama run qwen3:4b

# Download a model
ollama pull qwen3:4b

# See models on your computer
ollama list

# See what is currently running
ollama ps

# See model information
ollama show qwen3:4b

# Stop a running model
ollama stop qwen3:4b

# Delete a downloaded model
ollama rm qwen3:4b
Vale a pena lembrar de um pequeno detalhe:
ollama stop libera a memória.
ollama rm exclui efetivamente o modelo do seu computador.
A biblioteca Ollama é onde você pode procurar modelos para chat, codificação, raciocínio, visão e embeddings:
Recurso: ollama.com/search
Agora vem a parte útil
Quando o Ollama está em execução, ele fornece ao seu computador um endereço de IA local:
http://localhost:11434
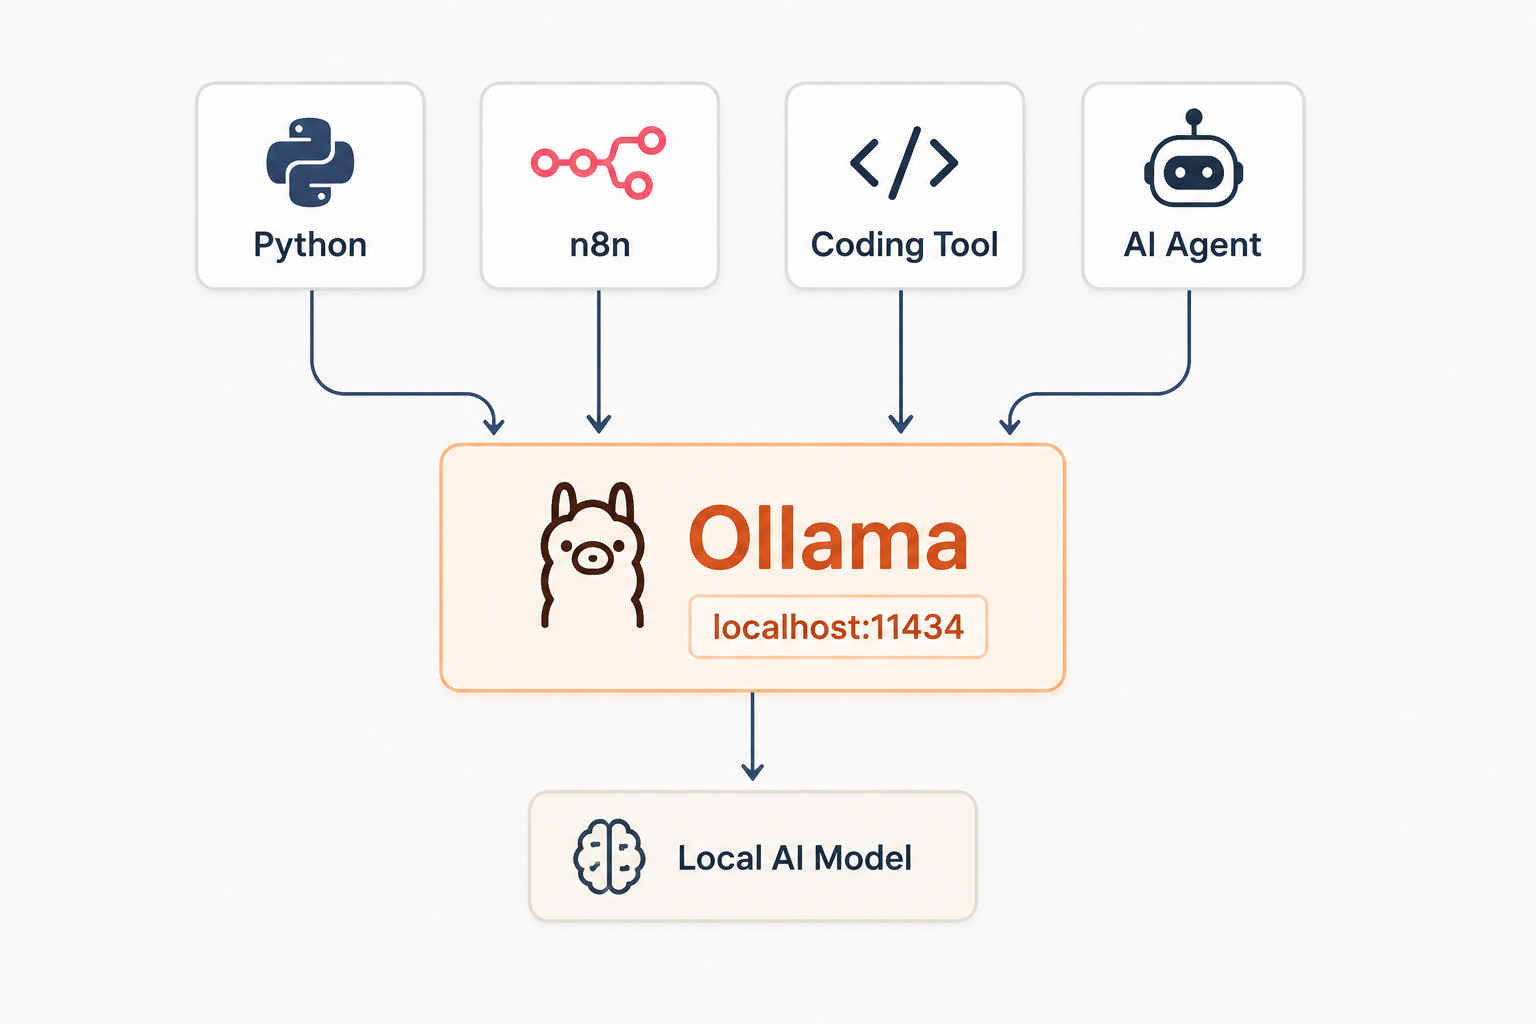
Isso parece técnico, mas a ideia é simples.
Outro programa pode enviar um prompt para esse endereço.
O Ollama passa o prompt para o seu modelo.
O modelo responde.
A resposta volta para o programa.
Então, em vez disto:
You → AI website → model
você pode ter isto:
Your app → Ollama → your model
É por isso que o Ollama se encaixa tão bem em fluxos de trabalho e agentes.
Experimente:
curl http://localhost:11434/api/chat -d '{
  "model": "qwen3:4b",
  "messages": [
    {
      "role": "user",
      "content": "Give me three short ideas for improving this product description."
    }
  ],
  "stream": false
}'
Você agora usou um modelo de IA local através de uma API.
Esse único passo abre quase todo o resto neste guia.
Use-o a partir de Python
Instale a biblioteca Python do Ollama:
pip install ollama
Então:
from ollama import chat

response = chat(
    model="qwen3:4b",
    messages=[
        {
            "role": "user",
            "content": "Summarize this note in three bullet points."
        }
    ]
)

print(response.message.content)
Agora o Ollama não é mais algo com que você conversa manualmente.
Ele faz parte do seu programa.
Você pode substituir o prompt por:
- feedback de clientes
- código
- anotações de reunião
- tickets de suporte
- descrições de produtos
- registros
- documentos
- registros de banco de dados
É aqui que a IA local se torna útil para o trabalho real.
Crie um trabalhador de IA reutilizável
Existe outro pequeno recurso do Ollama que eu gosto: Modelfiles.
Um Modelfile permite que você salve o comportamento que deseja em vez de escrever a mesma instrução longa todas as vezes.
Por exemplo, crie um arquivo chamado:
ModelfileColoque isto dentro:
FROM qwen3:4b

PARAMETER temperature 0.2

SYSTEM """
You are a document assistant.

When I give you text:
- explain it in simple language
- extract important names and dates
- list actions separately
- never invent missing information
- keep the answer short
"""
Crie o worker:
ollama create document-assistant -f Modelfile
Execute-o:
ollama run document-assistant
Agora você criou uma versão reutilizável do modelo.
Você poderia criar outra para programação:
SYSTEM """
You are a code reviewer.

Find:
- bugs
- security problems
- unnecessary complexity
- missing error handling

Give the smallest useful fix first.
"""
Ou uma para suporte ao cliente.
Ou pesquisa.
Ou controle de qualidade.
Ou descrições de produtos.
Isso não é um ajuste fino. Você não treinou um novo modelo. Você simplesmente salvou um modelo e suas instruções de funcionamento.
Conecte o Ollama ao fluxo de trabalho do n8n de ontem
É aqui que o curso começa a se unir.
O n8n lida com o fluxo de trabalho.
O Ollama lida com a etapa de IA.
Imagine isto:
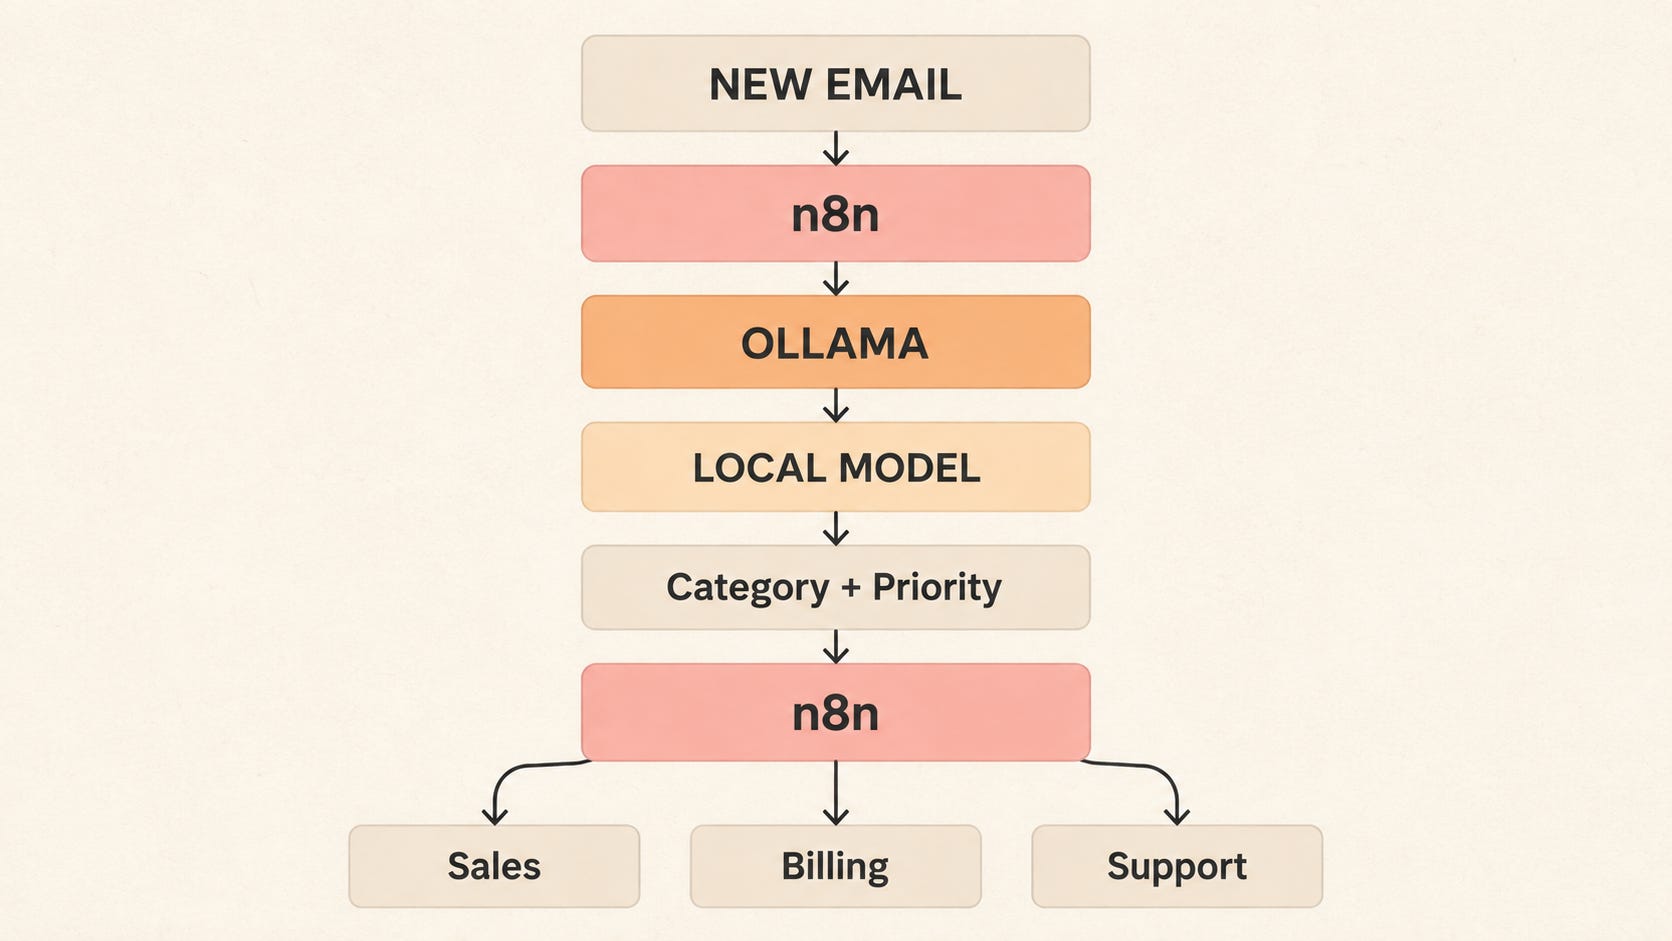
Ou:
Customer form
     ↓
    n8n
     ↓
   Ollama
     ↓
extract:
name
problem
priority
     ↓
save to database
O Ollama já possui uma integração com o n8n, então você pode usar um modelo do Ollama como o modelo de IA dentro de um fluxo de trabalho do n8n.
Esta combinação faz muito sentido.
O n8n movimenta o trabalho. O Ollama compreende o trabalho.
Um fluxo de trabalho local simples poderia ser:
- Monitore uma pasta.
- Quando um novo arquivo de texto aparecer, envie-o para o Ollama.
- Peça ao Ollama para resumi-lo.
- Salve o resumo.
- Envie um alerta apenas se o documento contiver algo importante.
O modelo não precisa ser brilhante.
Ele só precisa ser bom o suficiente para aquela etapa.
Essa ideia é importante.
Você não precisa do seu modelo de IA mais potente para cada tarefa pequena.
Torne a saída fácil para automação
Existe um problema em colocar IA dentro de fluxos de trabalho.
A IA gosta de conversar.
As automações não.
Uma automação normalmente precisa de algo limpo como:
{
  "category": "billing",
  "priority": "high",
  "customer": "John"
}
Nota:
After carefully reviewing the customer's message, it appears that...O Ollama suporta saídas estruturadas, incluindo JSON.
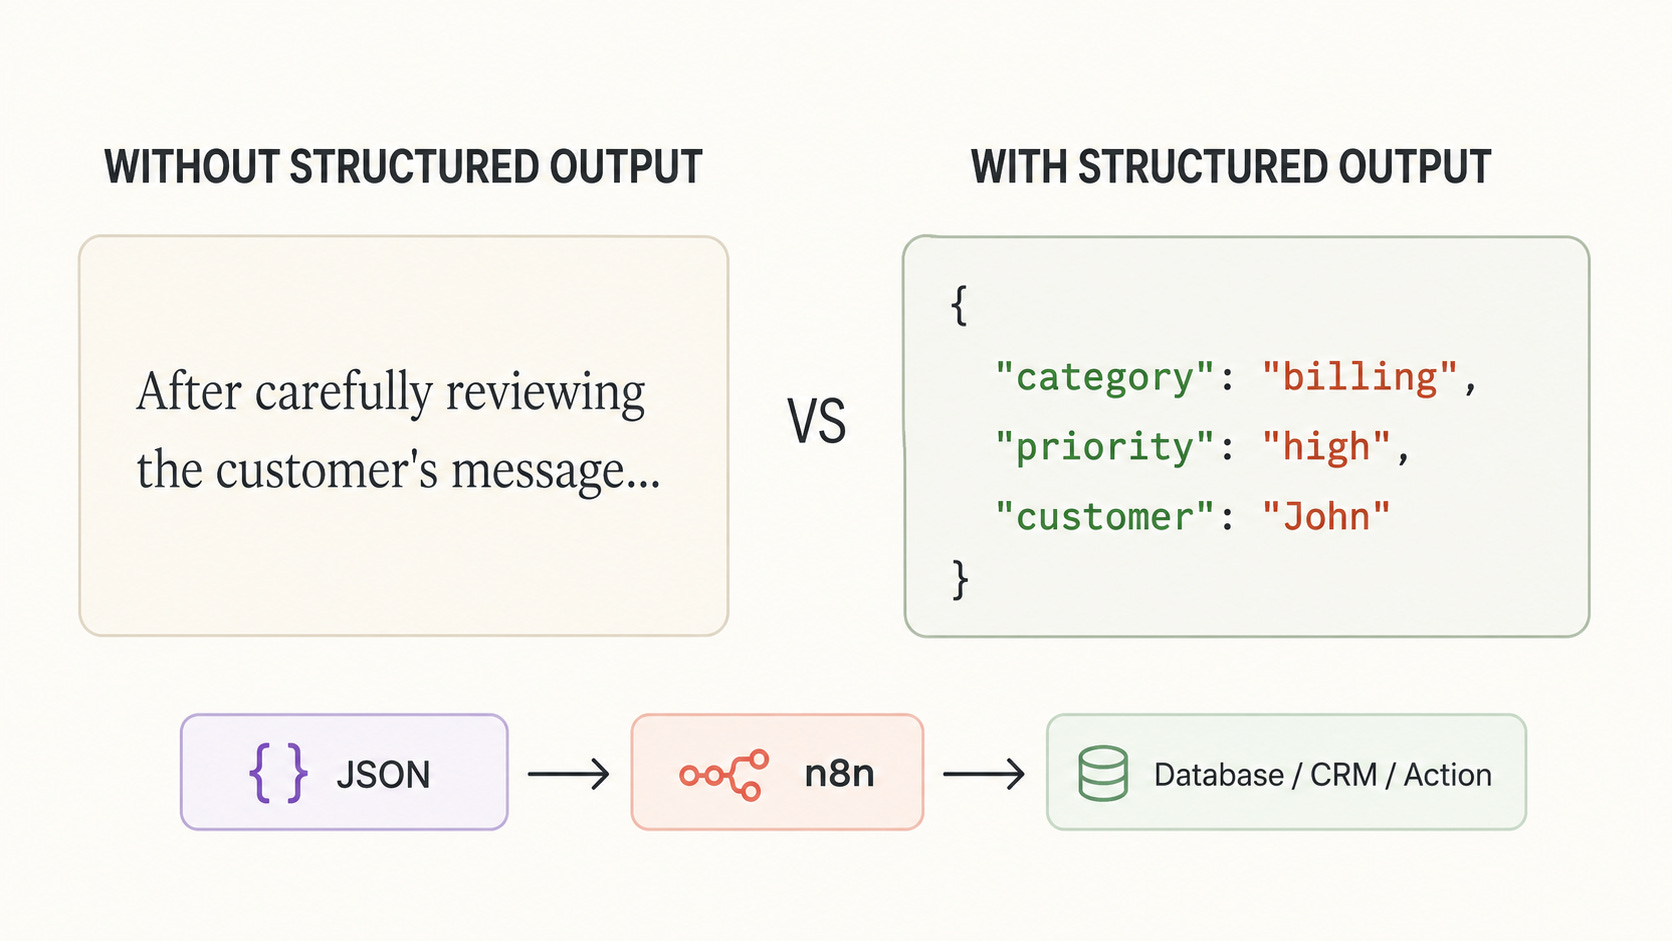
Isso torna muito mais fácil conectar um modelo a bancos de dados, APIs e automações.
Um prompt útil é:
Read the message below.

Return ONLY valid JSON.

Use this structure:

{
  "category": "",
  "priority": "",
  "summary": "",
  "needs_human": true
}

Rules:
- category must be billing, technical, sales or other
- priority must be low, medium or high
- summary must be under 30 words
- do not add any text outside the JSON

MESSAGE:
[paste message]
Esta é uma das maneiras mais fáceis de tornar a IA muito mais confiável dentro de um fluxo de trabalho.
Ollama também pode estar dentro de um agente de IA
Um agente de IA precisa de mais do que apenas um modelo.
Geralmente, ele precisa de:
Model
+
Tools
+
Context
+
A loop
O Ollama suporta chamadas de ferramentas.
Isso significa que o modelo pode pedir ao seu programa para executar uma função.
Exemplo:
User:
"What is the status of order 982?"
O modelo percebe que não sabe.
Ele pede uma ferramenta:
get_order_status(982)O seu programa executa essa função.
O resultado retorna:
Shipped. Expected Tuesday.O modelo usa essa informação para responder ao usuário.
Esse é um loop básico de agente. A atual API de chamada de ferramentas do Ollama suporta tanto chamadas de ferramentas normais quanto loops de agente de múltiplos turnos repetidos.
Isso se torna útil para:
- consulta ao banco de dados
- pesquisando arquivos
- verificando inventário
- lendo calendários
- chamando APIs
- executando código
- obtendo informações em tempo real
O modelo faz o raciocínio.
As ferramentas fazem o trabalho real.
Contexto não é memória
Essa é outra ideia que vale a pena entender desde cedo.
Se você conversar com um modelo por vinte mensagens, essas mensagens são o contexto.
Contexto é o que o modelo consegue ver no momento.
Não é memória permanente.
Se você quiser que seu sistema de IA se lembre de algo na próxima semana, armazene isso em algum lugar.
Por exemplo:
Customer conversation
       ↓
Database
       ↓
Retrieve useful history
       ↓
Give it to Ollama
       ↓
Answer
Para grandes quantidades de texto, o Ollama também pode criar embeddings.
Embeddings tornam possível pesquisar documentos pelo significado, em vez de pelas palavras exatas. Eles são comumente usados em sistemas RAG.
A ideia simples é:
Your documents
      ↓
turn them into searchable vectors
      ↓
find the useful pieces
      ↓
give only those pieces to the model
Não continue colocando tudo em um único prompt gigante.
Armazene primeiro. Recupere o que importa. Depois, pergunte ao modelo.
Esse padrão se torna muito importante quando seus fluxos de trabalho de IA crescem.
Local não significa que você deva permanecer local para sempre
O Ollama começou como uma ferramenta de IA local, mas agora também suporta modelos em nuvem.
Isso lhe dá três opções práticas.
1. Local
Execute o modelo em seu próprio hardware.
Bom para:
- arquivos privados
- trabalho repetido
- uso offline
- experimentar sem cobranças por token
2. Cloud
Execute um modelo maior através da nuvem do Ollama quando seu computador não conseguir lidar com ele.
3. Híbrido
Esta é a abordagem que acho mais interessante.
Use um modelo local pequeno para trabalhos simples:
classification
summaries
formatting
extraction
simple coding
routing
Em seguida, use um modelo de nuvem mais forte apenas quando a tarefa se tornar difícil.
100 routine tasks
      ↓
local Ollama model

5 difficult tasks
      ↓
strong cloud model
Isso pode reduzir o gasto de tokens sem forçá-lo a abrir mão completamente de modelos mais potentes. As leituras apontam repetidamente para esse padrão de local para volume e nuvem para trabalho pesado.
Um fluxo de trabalho simples que eu construiria primeiro
Não faça do seu primeiro projeto uma empresa autônoma.
Construa isto:
Assistente de Documentos Privados
Crie uma pasta chamada:
inboxSolte arquivos de texto nela.
Para cada arquivo:
- Leia o texto.
- Envie-o para o Ollama.
- Peça um resumo.
- Extraia as ações.
- Salve a resposta em outra pasta.
Prompt:
Read this document carefully.

Return:

SUMMARY
Maximum 5 lines.

IMPORTANT FACTS
Only facts clearly stated in the document.

ACTIONS
List anything that requires action.

DATES
List important dates.

RISKS
List anything that may create a problem.

If something is missing, say "Not provided".
Never guess.
Você pode fazer isso manualmente primeiro.
Em seguida, automatize com Python.
Depois, coloque no n8n.
Em seguida, adicione JSON estruturado.
Depois, adicione armazenamento.
É assim que eu aprenderia o Ollama.
Um fluxo de trabalho funcional ensina mais do que testar cinquenta modelos.
Algumas coisas que eu evitaria
Não baixe o maior modelo só porque o benchmark dele parece bom.
Não presuma que “local” significa que sua máquina consegue rodar todo modelo aberto.
Não dê contexto imenso a toda tarefa.
Não exponha a API local do Ollama abertamente à internet. A API local não usa autenticação por padrão, portanto, o acesso remoto precisa de proteção adequada.
Não confunda um Modelfile com treinamento.
Não construa memória aumentando infinitamente o prompt.
E não use um modelo de nuvem de fronteira para cada pequena classificação apenas porque está disponível.
Combine o modelo com o trabalho.
O Ollama começa a fazer sentido quando você para de conversar com ele
A primeira demonstração do Ollama é sempre a mesma:
ollama run ...Você faz uma pergunta.
Ele responde.
Legal.
Mas não é por isso que acho que o Ollama pertence a este curso de cinco ferramentas.
A versão útil do Ollama fica silenciosamente atrás de outra coisa.
Atrás de um fluxo de trabalho do n8n.
Atrás do seu script Python.
Atrás de uma ferramenta de codificação.
Atrás de um agente.
Atrás da busca de documentos privados.
Atrás de uma pequena automação rodando o dia todo.
Ontem aprendemos como conectar o trabalho de IA com o n8n.
Hoje adicionamos algo que podemos colocar dentro dessas conexões: nossa própria camada de modelo.
É aí que o Ollama se torna interessante.