Este é um guia completo, do início ao fim, sobre como adicionar uma camada de decisão à sua infraestrutura de agentes já existente.
Isso muda um aspecto da forma como você trabalha com IA: o modelo que escreve deixa de ser o modelo que julga.
O software está se tornando redundante. Os agentes são a tarefa, não o software que a executa. Você ainda precisa de um redator — só não precisa que ele também seja o juiz.
Resumindo: se você não vai ler cerca de 4.000 palavras, entregue isso ao seu agente:
mantenha seu escritor atual (gpt-6 astra, fable 5.1, ou qualquer outro que você use para rascunhos). Adicione o Jev como camada de avaliação — ele responde a perguntas de Escolha/Pontuação/Rejeição com base no seu rascunho e retorna decisões digitadas + probabilidades, sem geração de texto. Antes de publicar: estado = seu texto, perguntas = sua rubrica, ramificação com base em pontuação + rejeição + confiança. O Jev custa US$ 0,042 por milhão de tokens de entrada, a saída é gratuita e a TypeSafe oferece US$ 5 de crédito para começar.
Documentação: https://docs.typesafe.ai/introduction.md · Acesso: https://typesafe.ai
Você já paga tokens de fronteira para participar do draft. O erro é pagar tokens de fronteira novamente apenas para decidir se o draft será enviado.
introdução
Cada conjunto de agentes já possui um escritor. GPT-6 Astra. Fable 5.1. Qualquer coisa em que você confie para produzir palavras. A parte que ainda falha é a intermediária: a classificação, a pontuação, a rota, o “este navio ou depósito”.
A maioria das pessoas resolve esse problema intermediário pedindo ao mesmo modelo que escreveu a postagem para avaliá-la também. Você recebe um texto sobre se é bom ou não. Então você analisa o texto. Depois pede novamente e recebe um texto diferente . Isso não é um obstáculo — é apenas mais um rascunho com um custo maior.
Este guia não é uma frota de agentes recriada. Não é uma pilha de memória. Não se trata de uma afirmação de que o TypeSafe é distribuído dentro da OpenAI ou da Anthropic. São três fornecedores distintos. Seu código é o responsável pela integração.
O que você adiciona é uma camada de decisão: o modelo System One da TypeSafe, Jev. Até a data desta publicação (setembro de 2026), ele é distribuído como jev-1.13.0. Estado não estruturado de entrada. Decisões probabilísticas tipadas de saída. Sem geração de texto, nunca.
A aposta em dinheiro está no primeiro parágrafo. As três perguntas estão no meio. Os primeiros sete dias estão no final. Marque tudo — os quatro comandos que controlam o portão estão no final.
Por que o método LLM-como-juiz falha no caminho mais difícil
A maioria das plataformas que “usam IA” para controle de qualidade já possui um escritor. O problema é usar esse mesmo escritor como juiz.
o imposto sobre a prosa
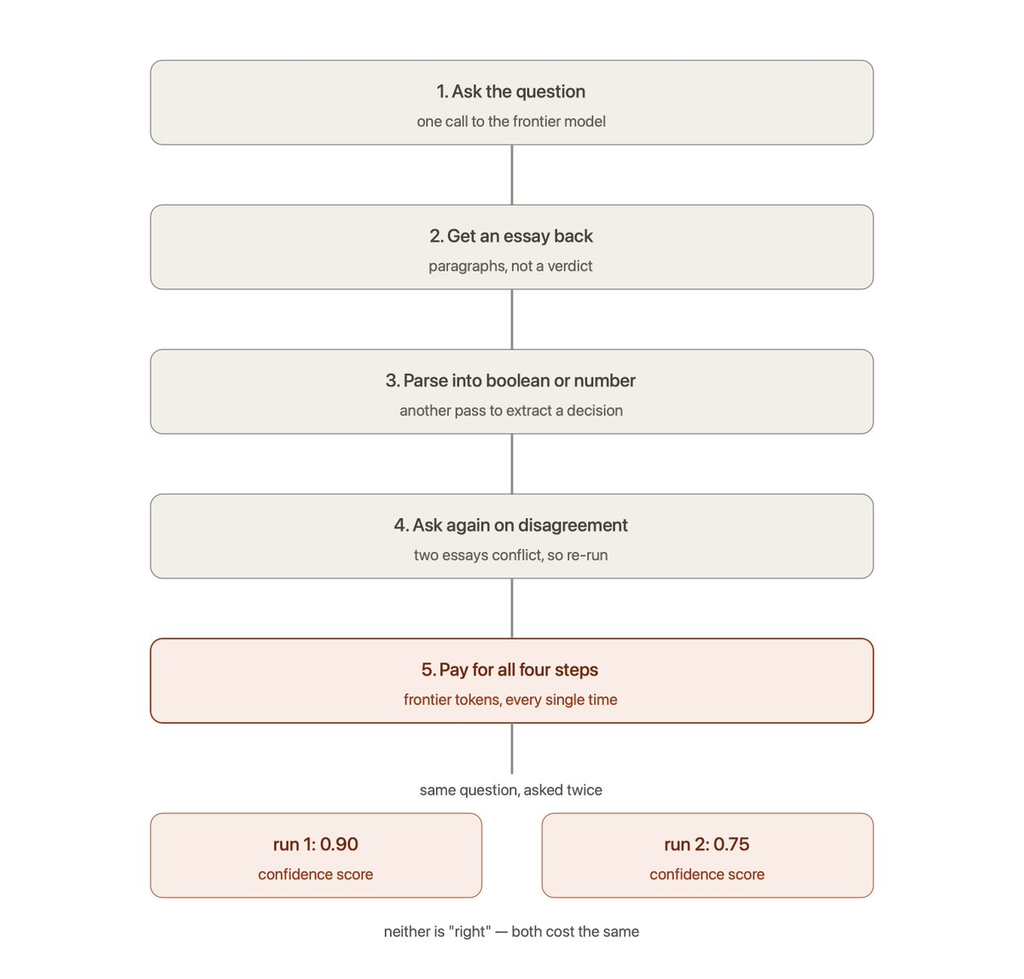
Um modelo de fronteira não responde “sim ou não”. Ele responde em parágrafos. Para chegar a uma decisão, você precisa:
- faça a pergunta
- receber de volta a redação
- Analise o ensaio e transforme-o em um valor booleano ou numérico.
- Pergunte novamente quando dois ensaios discordarem.
- Pague todas as quatro etapas com tokens de fronteira.
Esse é o preço a se pagar. Você está pagando à inferência mais cara da sua pilha para que ela execute a tarefa mais simples — escolher um número e fazer uma chamada. E a confiança dessa inferência não é calibrada. Se você perguntar duas vezes, receberá 0,9 e 0,75; nenhum dos dois está “certo”, ambos custam o mesmo.
Comparação de custos operacionais (GPT-6 Astra vs Fable 5.1 vs Jev)
| juiz | custo para avaliar um rascunho curto | saída | calibração |
|---|---|---|---|
| gpt-6 astra (openai) | US$ 10–50 por 1 milhão de tokens de entrada/saída | prosa que você deve analisar | não especificado |
| fábula de Claude 5.1 (antrópica) | US$ 10/US$ 50 por 1 milhão de entrada/saída | prosa que você deve analisar | não especificado |
| jev (seguro para tipos) | US$ 0,042 por 1M de entrada, saída gratuita | resposta digitada + probabilidade | treinado para calibração |
Uma sentença digitada que antes significava mais uma viagem de ida e volta ao tribunal pode, em vez disso, servir como um portão por frações de centavo. Isso representa toda a aposta.
O que as alternativas lhe reservam?
- Regras e expressões regulares. São gratuitas, e você deve escrevê-las primeiro — elas abrangem a metade óbvia. Mas uma regra é um veredito, não uma certeza. Sem número, não há barra, e sem barra, não há autonomia.
- Um segundo modelo de fronteira como juiz. Funciona, custa taxas de fronteira, confiança não calibrada. Você está dobrando a conta para obter um parágrafo que você analisa.
- Seu próprio classificador. Dados rotulados, um pipeline de treinamento, um problema de deriva que você resolve para sempre. Vale a pena em grande escala, absurdo para uma primeira implementação.
- Um modelo de decisão. A nova opção. Lê o mesmo estado, retorna um número que significa algo, com preço de infraestrutura em vez de preço de prosa.
Você pode escrever as regras à mão. Pode queimar astra em cada portal. Ou pode discar um número e guardar as fichas de fronteira para escrever.
O que Jev faz em um minuto
Jev é o modelo principal da TypeSafe e o primeiro modelo System One — nomeado em homenagem ao pensamento rápido e intuitivo de Kahneman.
Um modelo System One entende a linguagem natural da mesma forma que um LLM, mas não foi projetado para gerar texto. Ele foi projetado para tomar decisões. Você envia a ele um estado mais um mapa de perguntas digitadas ; ele retorna respostas digitadas, probabilidades e (no caso de Escolha/Pontuação) o nível de confiança.
texto simples
state + questions  →  POST /v1/systemone  →  typed answers
                                                + probabilities
                                                + confidence
Sem prosa. Sem analisador sintático no meio. Seu código ramifica diretamente na resposta.
a amputação
É isso que diferencia o Jev dos modelos de raciocínio lógico que você já usa: ele não consegue escrever. Ele não gera respostas, não rascunha posts nem explica seu raciocínio. Isso pode parecer uma limitação, mas é justamente a sua proposta. Um modelo que não consegue gerar texto não pode te convencer do contrário e não pode complementar a resposta com argumentos que você teria que analisar de qualquer forma.
IDs de envio, ponto de extremidade, contexto
- ID do modelo: jev-1.13.0. os aliases jev-latest e jev-preview apontam para isso hoje.
- endpoint: POST https://api.typesafe.ai/v1/systemone — um endpoint para todos os modelos do System One; o campo do modelo seleciona.
- Contexto: 64 mil tokens por solicitação; 32 mil para o estado mais a pergunta mais longa.
- Entrada: somente texto (string, objeto JSON ou array de texto). Sem imagens, áudio ou vídeo — esses elementos devem ser pré-processados para texto primeiro.
- Preço: US$ 0,042 por 1 milhão de tokens de entrada, saída gratuita.
acesso e os 5 dólares
A API direta da TypeSafe oferece acesso antecipado e é controlada por lista de espera, com chaves emitidas em lotes. Três gateways atendem o Jev atualmente sem lista de espera: Vercel AI Gateway, OpenRouter e Cloudflare AI Gateway — todos com o mesmo preço de US$ 0,042, cada um com sua própria string de modelo.
Ao obter uma chave, o TypeSafe oferece US $ 5 de crédito gratuito — o suficiente para mais de cem mil decisões. Com um custo de US$ 0,042 por milhão de tokens de entrada e saída gratuita, US$ 5 não é um período de teste. É mais poder de decisão do que a maioria dos sistemas executa em um ano.
Válido ≠ correto. As probabilidades de Jev são calibradas em grupos de previsões — não há garantia de que qualquer resposta individual esteja correta. Defina um limite, valide com seus próprios dados e mantenha humanos nas decisões que comprometem a reputação.
escolha, pontuação, noul — as únicas três formas
Jev faz exatamente três tipos de perguntas. Cada uma retorna uma resposta digitada diferente. Esse é todo o vocabulário do meio.
escolha
Escolha uma opção de um conjunto definido.
texto simples
"which team should handle this ticket?"
  → choice: "billing"
    probabilities: {billing: 0.85, technical: 0.15, sales: 0.0}
    confidence: 0.78
Use-o para roteamento — qual modelo, qual fila, qual caminho de escalonamento.
pontuação
Avalie o estado em relação aos níveis ordenados que você escrever.
texto simples
"how frustrated is this customer?"   0 = calm  1 = frustrated  2 = very frustrated
  → score: 1.4
    confidence: 1.0
Use-o para classificação — qualidade, risco, adequação, toxicidade. Os níveis obrigam você a definir o que é “bom o suficiente” e a etapa que todos pulam: “preciso, mas inútil”.
noul
Uma pergunta de sim/não, retornada como a probabilidade de a resposta ser sim.
texto simples
"does this post ask for likes or replies?"
  → noul: 0.95
Use isso para portões — isso é urgente, isso é uma isca, isso solicita um reembolso, isso prejudica a reputação.
o sistema um hábito
Combine os três em uma única chamada . O Jev avalia cada pergunta em paralelo e isoladamente, considerando o mesmo estado. Perguntas independentes não se contaminam mutuamente — sem deterioração de contexto. Adicionar uma pergunta praticamente não altera o tempo de resposta.
Escreva cada pergunta como uma verificação intuitiva e pontual. Se uma chamada precisar de dois fatores independentes, faça duas perguntas. Não peça para Jev raciocinar sobre eles — decomponha no código.
Quadro 3: o gerador que você tem, o juiz que você adiciona
Todo o agente é um ciclo. Geração e julgamento, rodada após rodada.
texto simples
perceive  →  decide  →  act  →  observe  →  decide  →  act
                ↑                              ↑
             jev is here                   jev is here
Você não descarta seu modelo de geração. Você intercala uma chamada de decisão em cada etapa do loop que atualmente consome uma geração inteira para decidir.
Gerador antigo. Juiz novo. Mesmo loop. Esse é o quadro 3.
Os cinco movimentos que todo agente faz.
Um agente não é um único julgamento. São os mesmos cinco, repetidos.
1. rota — qual ferramenta ou manipulador
Escolha. Qual modelo, qual ferramenta, qual operador controla este turno? Em vez de uma pergunta gigante que pontua metade de cada opção, pergunte apenas uma opção e direcione a execução.
texto simples
"which handler should own this turn?"
  → choice: "code" | "search" | "billing" | "escalate"
2. Classificação — qual candidato é realmente relevante
Pontuação. Quando a recuperação retorna dez blocos, mas o contexto se encaixa em três, classifique-os. Solicite uma pontuação por candidato (ou agrupe-os) em vez de tentar incluir tudo e torcer para dar certo.
texto
"Qual a relevância deste trecho para a consulta?"
  → pontuação por bloco → manter os N melhores
3. Verificar — o resultado obtido realmente satisfez a tarefa?
Não, o agente afirma que está concluído. Verifique a solicitação e as evidências antes de autorizar qualquer ação ou retorno.
texto
"A resposta do agente satisfez a solicitação do usuário?"
  → noul: 0,95 → limiar
4. Escalar — autônomo vs. humano
Confiança. A resposta indica o quê ; a confiança indica se você deve agir . Alta confiança, resultado claro → agir. Baixa confiança → agir de forma humana. Ações de alto impacto permanecem humanas, não importa quão claros os números pareçam.
bash
if confidence < 0.6:  escalate
elif noul(failure):  block
else:  act
5. loop-health — está travado? O que fazer?
Noul + Choice. No meio da partida, o agente está em loop, travando ou progredindo? Interrompa uma partida ruim no turno 12 em vez de deixá-la consumir recursos até o turno 20.
texto
"O agente está preso/repetindo a mesma ação que falhou?"
  → opção: continuar | trocar_modelo | reiniciar_limpo | escalar_humano
O restart_clean é uma opção que vale a pena aproveitar, mesmo que você não desenvolva mais nada: reconstrua a solicitação mantendo a tarefa do usuário e as saídas da ferramenta, descarte o contexto de raciocínio corrompido, para que um erro não se transforme em dez.
Conecte-o ao circuito — o passo a passo completo
Os cinco movimentos entram no loop que seu agente já executa, não depois dele. Um agente que já agiu manterá o que começou. Decisão após a ação é teatro. Decisão antes da ação é um portão.
Exemplo: um agente que lê, recupera e age
Uma jogada, três chamadas de Jev, tudo barato:
texto
1. estado da rota = tarefa → escolha: qual manipulador (código / pesquisa / perguntar a um humano)
2. estado de classificação = bloco → pontuação por bloco recuperado → manter os N melhores
3. verificar estado = resposta → não: a saída satisfez a tarefa?
   + saúde do loop → escolha: continuar / alternar / reiniciar_limpar / escalar
Seu código se ramifica entre cada etapa. O modelo de geração só é executado quando uma etapa realmente precisa de saída.
exemplo de solicitação
bash
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer ***" \
  -H "Content-Type: application/json" \
  -d '{
    "state": {"task": "fix the failing test", "response": "i changed the config and re-ran", "attempts": 3},
    "model": "jev-latest",
    "questions": {
      "satisfied": {"type": "noul", "instructions": "Does the response actually fix the failing test?"},
      "stuck":     {"type": "noul", "instructions": "Is the agent repeating the same failed attempt?"},
      "next":      {"type": "choice", "instructions": "What should happen next",
                    "criteria": {"continue": "making progress", "switch_model": "it stalled",
                                 "restart_clean": "context is polluted", "escalate_human": "cannot resolve"}}
    }
  }'
Limiares de confiança — agir versus intensificar
A resposta lhe diz o quê . A confiança lhe diz se deve agir ou não .
- alta confiança, limpo → agir
- Alta confiança, arriscado → bloquear/ativar um caminho de segurança
- Baixa confiança → encaminhar para um humano
- Ações de alto impacto continuam sendo humanas, independentemente dos números.
bash
if noul(stuck) > 0.8:  restart_clean or switch_model
elif choice(next) == "escalate_human":  hand off
elif confidence < 0.6:  escalate
else:  continue
sensação de dinheiro
Com um custo de entrada de US$ 0,042 por milhão de tokens e saída gratuita, uma chamada de decisão sobre algumas centenas de tokens de estado custa aproximadamente US$ 0,00002 . Você pode se dar ao luxo de incluir uma decisão em cada etapa do processo, não apenas no final. O recurso escasso é a sua atenção em escalonamentos de baixa confiança, não o custo dos tokens.
forma de loop do agente — todo o ritmo
texto
enquanto não estiver concluído:
    resposta = generator.run(tarefa) # seu modelo de fronteira, somente geração
    estado = {tarefa, resposta, tentativas} # seu código monta o contexto
    ok = jev.noul(estado, "satisfeito?") # camada de decisão
    nxt = jev.choice(state, "next?") # camada de decisão
    ramificação no código em noul + escolha + confiança
A geração produz. Jev decide. O código é o dono do ramo.
lote muitas perguntas sobre um estado
por que em lotes
Cada pergunta em uma chamada é avaliada em paralelo e isoladamente em relação ao mesmo estado. Adicionar uma pergunta praticamente não altera o tempo de resposta, e as perguntas não podem alterar o contexto umas das outras. Uma única chamada pode abranger toda a superfície de decisão de uma rodada.
o que colocar no estado
Os fatos relevantes, em campos nomeados: a tarefa, a resposta mais recente, as saídas da ferramenta, a contagem de tentativas, qualquer política. O Jev lê um estado limpo e estruturado melhor do que um amontoado de contexto confuso.
paralelo como um hábito
Faça as perguntas de julgamento independente em conjunto, não em sequência. Emita uma segunda solicitação somente quando uma resposta anterior for necessária para obter evidências ou construir um novo cenário. As perguntas independentes não precisam depender umas das outras.
O que dá errado?
Essas são as armadilhas, nomeadas para que você não tropece nelas.
Armadilha 1 — tratar isso como bate-papo
Jev não é um modelo de chat. Não há array de mensagens, nem temperatura, nem /chat/completions. Apontar um cliente OpenAI para ele falha. Você envia o estado e as perguntas para o endpoint do SystemOne ou usa um SDK.
armadilha 2 — dicas de verificação de vibração
“Isso parece certo?” retorna ruído. Escreva os níveis. Force o nível intermediário. Uma pontuação sem rubrica é um palpite com um certo grau de confiança.
armadilha 3 — matemática dentro de jev
Jev tem dificuldades com matemática e datas. Faça cálculos aritméticos, de custos e comparações de datas no código. Nunca peça ao modelo de decisão para calcular isso.
armadilha 4 — força de geração
Jev não pode escrever. Se uma etapa precisar de saída, envie-a para o modelo de geração. Envie apenas decisões para Jev. Pedir à camada de decisão para gerar é como você obtém uma chamada estruturada que retorna um resultado sem sentido.
Armadilha 5 — esquema ≠ correção
Uma resposta digitada garante a interface , não a verdade . O fato de Jev retornar “0,9” não significa que a coisa esteja 90% correta. Valide com seus próprios dados e defina o limite com base nas suas próprias consequências.
Armadilha 6 — estado ruidoso + pressupostos ingleses
Jev lê melhor a linguagem natural com um estado limpo e estruturado. Forneça a ele os fatos relevantes em campos nomeados, não uma parede de contexto desconexo.
Armadilha 7 — decidir depois do ato
Tomar a decisão depois que o agente já agiu ou a fila já aceitou a saída. O agente envia o pedido. A pontuação chega tarde demais. Decida antes da ação. Esta é a única regra que não custa nada e resolve tudo.
O que eu não construí (lacunas honestas)
- Os formulários de solicitação acima usam os formatos de exemplo documentados; os limites reais exigem sua própria rubrica, ajustada às suas tarefas.
- Jev aceita apenas texto — qualquer entrada de imagem/áudio/vídeo deve ser previamente convertida em texto.
- A confiança não é uma licença para agir; é um sinal para direcionar a ação. Os humanos permanecem em chamadas de alto risco.
- Agrupar várias perguntas para manter a latência estável, mas medir os orçamentos reais de requisição — perguntas extras ainda usam tokens.
- Este guia pressupõe um modelo de geração em que você já confia. Ele não compara o desempenho do seu gerador diretamente com o GPT-6 Astra ou o Fable 5.1.
- Os cinco movimentos representam uma forma inicial, não uma taxonomia completa de agentes.
primeiros sete dias / o manual
Faça uma fatia fina. Não ferva a pilha inteira.
Dia 1 — mantenha o gerador, abra o meio
- Mantenha seu modelo da geração atual. Não substitua o módulo LLM.
- Obtenha um caminho Jev: a lista de espera na API direta da Typesafe para sua própria chave (com o crédito de US$ 5) ou um gateway (Vercel / OpenRouter / Cloudflare) sem lista de espera.
- Leia as notas sobre irregularidades uma única vez — conheça os modos de falha antes de formular qualquer pergunta.
Dia 2 — escreva perguntas digitadas
- Escreva as cinco perguntas de decisão do formato do loop: rotear, classificar, verificar, escalar, integridade do loop. Ou comece com duas: verificar + escalar.
- Uma ideia por pergunta. Sem testes de clima.
- Escreva os níveis para cada pontuação. Force o nível intermediário.
Dia 3 — telefonar para uma chamada de decisão
- estado = {tarefa, resposta, tentativas}. perguntas = seu mapa. modelo = jev-latest enquanto explora.
- Baseie-se em noul + escolha + confiança antes que seu agente aja.
- Registre todas as respostas. Registre cada motivo de escalonamento como uma string separada.
Dia 4 — Limites conscientes em relação ao dinheiro
- Com um custo de entrada de US$ 0,042/mtok e saída gratuita, o cálculo de volume é suficientemente barato para ser executado em cada iteração do loop.
- O recurso escasso é a sua atenção às escalações de baixa confiança, não o valor simbólico da fatura.
- Defina limites. Valide em suas próprias tarefas. Não considere os múltiplos de latência do fornecedor como verdade absoluta.
dia 5 — geração de resíduos no meio
- Se uma etapa precisar de saída → seu modelo de geração (gpt-6 astra / fable 5.1).
- se uma etapa requer uma decisão → Jev.
- Se uma etapa exigir cálculos matemáticos ou datas → código.
dia 6 — portões da confiança
- Pontuações de baixa certeza aumentam em vez de agirem automaticamente.
- bloqueio de nós de falha de alta certeza / risco.
- Ações de alto impacto continuam sendo humanas mesmo quando os números parecem impecáveis.
Dia 7 — execute uma tarefa real em loop.
- fix jev-1.13.0 assim que os limites forem ajustados.
- gerador → jev → act. esse é todo o loop do quadro 3.
- Só então amplie o leque de decisões. Não invente parâmetros de referência.
o manual (compacto)
- 3 camadas — geração (seu modelo) · julgamento (jev) · ação (seu código/ferramentas).
- 3 primitivas — escolha · pontuação · noul. misturam em uma chamada, em paralelo em um estado.
- 1 endpoint – POST https://api.typesafe.ai/v1/systemone , modelo jev-1.13.0 / jev-latest.
- 1 investimento — entrada de $0,042/mtok, saída gratuita, crédito inicial de $5.
- 5 ações — rota · classificação · verificação · escalonamento · saúde do loop.
- 1. A lei decide antes do ato. O julgamento após o ato é teatro.
- 1. Recusa — nunca peça a Jev para gerar.
- 7 dias para concluir uma tarefa real no ciclo. Não se trata de uma reescrita completa da frota.
Você não precisa de um modelo de nova geração. Você precisa de uma camada de decisão entre o gerador que você já possui e as ações que você já realiza.
Salve esta configuração. O llm gera. O jev decide. O loop age.
Resumidamente
Eu mostrei como construir uma pilha de agentes de IA com o Jev como camada de decisão — e não como gerador.
O que isso faz por você? Permite que você faça julgamentos precisos em cada etapa do processo, sem desperdiçar tokens de geração de fronteira em cada chamada de rota/classificação/verificação/escalonamento. Sua atenção se concentra em escalonamentos de baixa confiança e no ajuste de critérios, e não em analisar mais um texto que finge ser uma decisão.
Por que isso era difícil antes? O gerador também era o juiz. Prosa entra, prosa sai, um analisador sintático no meio, dois parágrafos diferentes se você perguntasse duas vezes. As regras capturavam a metade óbvia. Um modelo de segunda geração como juiz, taxas de fronteira de custo. Seu próprio classificador era um problema de treinamento que você ainda não queria.
O que resolve isso. Um modelo baseado apenas em decisões. Sistema um. jev. Estado de entrada. Escolha/pontuação/não saída. Confiança na escolha/pontuação para agir versus intensificar. Não como uma probabilidade de 0 a 1. O código controla a ramificação. Preço: US$ 0,042/mtok de entrada, saída gratuita, com US$ 5 de crédito inicial.
a pilha em uma linha:
texto
seu gerador → produz saída
jev-1.13.0 → rotas / classificações / verificações / escalonamentos / verificação de integridade
seu código → ramificações e ações
Tudo isso nas ligações que você realmente faz:
bash
# generation: your existing model
# decision:
curl -s https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer ***" \
  -H "Content-Type: application/json" \
  -d '{"model":"jev-1.13.0","state":{"task":"...","response":"..."},"questions":{...}}'
# then branch in your code before the agent acts
Conclusão
Gerador antigo. Juiz novo. Mesmo ciclo.
Esse é o guia completo. Mantenha seu modelo de geração para a saída. Coloque o Jev em cada chamada de rota/classificação/verificação/escalonamento/saúde do loop que antes era uma ida e volta ao LLM. Decida antes da ação. Recuse a geração no meio do processo. Ajuste os limites com escalonamentos, não com vibrações.
Custo de admissão: uma chave de API (lista de espera ou portal), US$ 5 em créditos, cinco perguntas digitadas e uma tarefa que precisa ser aprovada antes de uma decisão ser tomada.
Você não precisa de permissão para adicionar uma camada de decisão. Você precisa de uma chave, cinco perguntas e um loop que precisa justificar sua própria próxima etapa.
Salve a configuração. Envie o componente intermediário.