Na semana passada, foi lançado o Bun 1.4.
Esta versão contém a reescrita do Bun, originalmente escrito em Zig, para Rust, com mais de um milhão de novas linhas de código em Rust. Embora isso tenha causado bastante polêmica na comunidade de programação em relação à mudança de linguagem, acredito que o mais importante sobre este lançamento seja a forma como a reescrita foi feita e a sua escala. Os detalhes disso, juntamente com minhas próprias experiências e os avanços iminentes na área de IA, me levam a crer que chegamos ao fim da programação como a conhecemos.
O que quero dizer com isso é que acredito que o ato de escrever código manualmente e ter outros humanos revisando-o para criar um software útil e funcional está caminhando para a extinção. Ou, no mínimo, será ofuscado pela avalanche de softwares úteis e funcionais que serão criados por agentes, com humanos revisando apenas o resultado final, e não o código em si. Teremos mais softwares do que jamais tivemos, mas a maior parte do código não terá sido escrita ou sequer lida por humanos.
Sem dúvida, haverá também uma montanha de software ruim. Software cheio de bugs, inútil, terrível e ofensivo, que não se conforma ao senso estético, propósito ou estilo de nenhum programador. Mas também haverá software bem projetado e funcional, que resolve problemas reais, mas que ainda não foi revisado em detalhes por olhos humanos.
Essa explosão no uso de software já pode ser vista neste gráfico da publicação do GitHub sobre a interrupção de 17 de agosto :
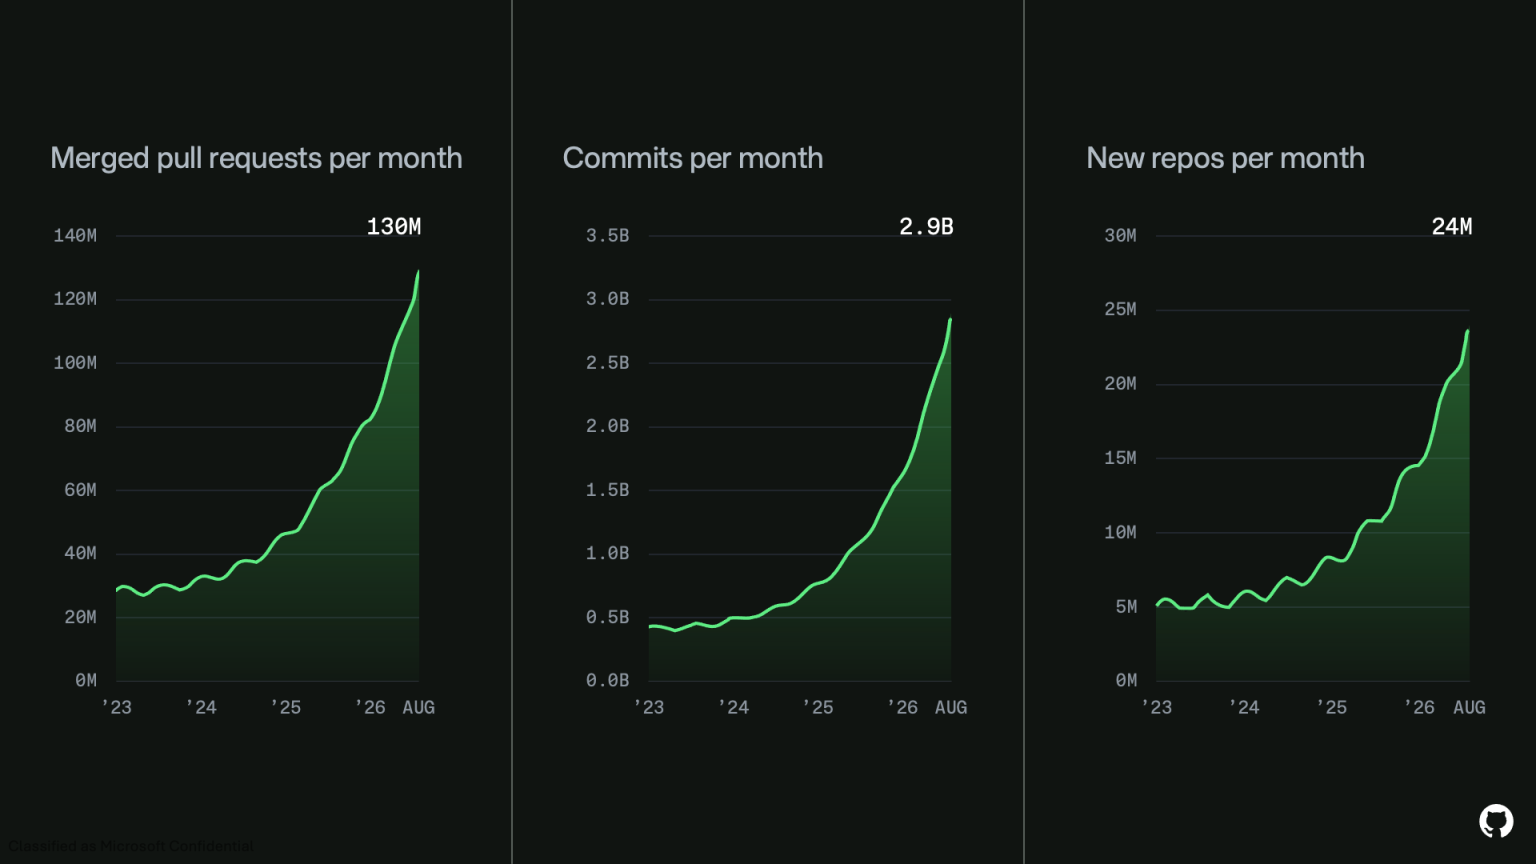
Desde o ano passado, houve um aumento exponencial acentuado na quantidade de código produzido. Minha teoria é que a maior parte disso se deve a projetos paralelos, projetos internos de empresas (tipo “skunk works”) ou projetos para usuários individuais. Coisas que são consideradas não críticas. Na maioria das empresas, ainda existe uma resistência organizacional significativa para desenvolvedores individuais que entregam o dobro de código quando se trata dos produtos que impulsionam o negócio, quanto mais 10 ou 100 vezes mais.
Quase todo o código nesses gráficos foi produzido por modelos que atualmente não estão na vanguarda. Foi produzido pelos modelos de vanguarda de meses atrás, ou seja, não Fable 5 e não GPT 5.6 Sol.
Os desenvolvedores da Anthropic e da OpenAI vivem em um futuro próximo.
Ao ler os detalhes da reescrita do Bun Rust , os principais destaques são que ela foi impulsionada por um único desenvolvedor, Jarred Sumner, trabalhando com uma versão pré-lançamento do Fable 5 e um orçamento de tokens aparentemente ilimitado. Ele criou a estrutura e o framework para que os agentes trabalhassem em paralelo e traduzisse a base de código Zig para Rust.
Ao longo de 11 dias, vários agentes geraram 6.778 commits e consumiram tokens suficientes para que o custo da API fosse de aproximadamente US$ 165.000.
Lembro-me de quando a polêmica em torno dessa reescrita surgiu no início de maio, bem antes da publicação do post acima ser escrita. Ela só foi revelada por meio de uma fusão da reescrita , que mostrou +1.009.257 -4.024 em alterações. Fiquei impressionado com a escala e teorizei que eles haviam conseguido isso com o Mythos.
Além disso, estou morrendo de vontade de saber se isso foi feito com fichas Mythos ilimitadas. Será que esse é o futuro próximo para o resto de nós? Ou será que já é o presente e eles fizeram isso com fichas Opus 4.7? Meu palpite é que seja a primeira opção. Então, é uma prévia do que será possível ainda este ano.
Naquela época, minha experiência era de que eu não acreditava que algo assim fosse possível com o Opus 4.7, então deve ter sido o Mythos, ainda não lançado, que possibilitou uma reescrita como essa que realmente funcionou.
O fato de uma IA ter escrito 1 milhão de linhas de código e depois refinado esse código ao longo dos meses seguintes para produzir um software confiável que atualmente roda em milhões de máquinas de desenvolvedores é absolutamente impressionante. E você pode dizer: “Bem, não é tão impressionante assim, porque eles tinham um oráculo para comparar, então foi simples migrar de uma linguagem para outra”, mas acho que isso subestima toda a situação. Se você conseguir construir um sistema de verificação e fornecer as instruções corretas, a IA pode produzir um software altamente complexo e sofisticado, e pode continuar a refiná-lo até que simplesmente funcione.
Se você prestar atenção ao que os desenvolvedores da Anthropic e da OpenAI têm dito sobre o X nos últimos meses, verá que cada um deles publica dezenas ou centenas de PRs por semana e que mudaram o foco para camadas mais altas da arquitetura. Isso faz sentido, já que não é realmente possível para um desenvolvedor revisar minuciosamente centenas de PRs de código toda semana enquanto também produz seu próprio trabalho.
Se levarmos em consideração o que eles dizem publicamente, eles não estão mais fazendo uma revisão minuciosa de cada linha de código que é lançada. Eles estão dedicando seu tempo a construir sistemas, prompts e ferramentas de verificação para que as IAs produzam seu software em escala e com alta velocidade. Pelo menos é essa a minha interpretação quando eles falam sobre loops.
No entanto, eles operam em um mundo onde têm acesso ilimitado ao Fable e ao Astra (o próximo modelo da OpenAI). Eles vivem em um futuro próximo que nós, meros mortais, provavelmente experimentaremos daqui a um ano. A experiência deles com o uso de IA para desenvolver software não é a mesma que a nossa, que trabalhamos no campo esperando nossa cota semanal de Fable ser reiniciada.
O lançamento do Bun 1.4 deve lhe dar uma ideia do que é possível ao combinar a inteligência de um Fable com tokens praticamente ilimitados. Entrega de software em escala, que funciona, como comprovado em milhões de implantações em funcionamento.
Meu relato de experiência em campo.
Tenho duas experiências recentes para compartilhar. Minha impressão é que o Fable é qualitativamente diferente dos modelos anteriores, de forma semelhante à diferença que as pessoas notaram no Opus 4.5, lançado no final de novembro passado. Ele ultrapassou um limite, permitindo produzir mais com maior direcionamento e menos supervisão. Consigo fornecer os requisitos, a arquitetura e as instruções para um recurso que desejo desenvolver, e ele é capaz de criar uma primeira versão totalmente funcional em várias horas de trabalho, sem qualquer outra intervenção minha.
Meus dois exemplos são recursos que não foram lançados no InfluxDB, mas são novas funcionalidades que eu desenvolvi em um fork. Escolhi esses dois exemplos para ver o que era possível com o novo modelo.
A primeira é a integração com o Iceberg, que torna os dados do InfluxDB acessíveis por meio da API REST do Iceberg ou em um bucket S3 externo e catálogo do Glue. Essa é uma funcionalidade complexa que requer:
- API e CLI para habilitar o recurso
- Implementação da API REST Iceberg
- Fortes ligações com o compactador para criar os manifestos Iceberg e os dados Parquet no armazenamento externo.
- A criação do Iceberg manifesta ou solicita ao Glue.
- API S3 implementada no InfluxDB para casos de uso que não sejam de exportação.
Isso representa milhares de linhas de código de implementação e teste. Elaborei o projeto arquitetônico e os requisitos básicos e, em seguida, instruí o Fable a realizar o trabalho por meio de subagentes, acionando revisões de código e supervisionando o processo. Quatorze horas depois, ele havia produzido uma versão funcional. Então, pedi que verificasse tudo de ponta a ponta com um cluster InfluxDB em execução, usando DuckDB e PyIceberg como clientes externos. Ele corrigiu alguns bugs e confirmou que tudo funcionava corretamente.
O segundo exemplo é a criação de um sistema de replicação de dados de borda para o InfluxDB. Trata-se de múltiplos nós individuais do InfluxDB executados como satélites que replicam periodicamente os dados compactados para um cluster central do InfluxDB. Ele define:
- API para definir o que será replicado e com qual frequência.
- CLI para acessar o acima
- Atualizações no compactador, usado para filtrar, agregar e criar dados compactados para replicação, juntamente com o rastreamento para saber o que aumentou e o que permanece inalterado.
- API para o nó de borda acessar informações do catálogo a serem usadas na carga útil de replicação.
- API para receber blocos de dados compactados no pipeline.
- Métricas e tabelas do sistema permitem a visibilidade de toda a configuração.
Elaborei a arquitetura e dei exemplos de como deveria ser a experiência do usuário. Colaborei com a Fable para criar um design e, em seguida, deixei que eles executassem o trabalho, atuando como supervisor. Vinte e oito horas depois, tínhamos uma implementação praticamente funcional.
Em seguida, instruí o sistema a implantá-lo em nossa infraestrutura de testes na AWS e observar as métricas e os logs, corrigindo os bugs conforme necessário. Após algumas iterações curtas, chegamos a uma implementação completa e funcional, que permanece em execução até hoje. Mais tarde, cheguei até a criar uma interface de usuário que exibe a ação de replicação entre os nós, com as respectivas taxas de transferência de dados, só por curiosidade.
É claro que nenhuma dessas coisas está atualmente disponível para compra ou com suporte, e não é o que eu chamaria de software pronto para produção. Então, você poderia dizer o que muitos dizem sobre IA, que ela ajuda a lançar o protótipo mais rapidamente. Mas isso não faz justiça ao seu potencial.
O protótipo é um software funcional. E o aprimoramento e os testes desse protótipo são ainda mais facilitados por ciclos de melhoria contínuos com IA. Ele se torna melhor com mais testes e verificações, não por meio de revisão humana de código, mas sim por meio do uso e dos testes.
Eu fiz cada uma dessas tarefas com uma cota semanal de Fable e minha assinatura (tive que esperar uma semana entre elas). O que eu não consegui fazer foi colocar isso na nuvem, em um ciclo de melhorias com créditos ilimitados de Fable. Não podemos arcar com as centenas de milhares de dólares em gastos mensais que eu provavelmente acumularia se enviasse o melhor agente da Fronteira para fazer tudo por mim 24 horas por dia, 7 dias por semana.
Jarred criou a reescrita em Rust em 11 dias, mas depois disso, agentes trabalharam na melhoria contínua por meses antes de lançá-la como uma versão oficial com suporte. O protótipo é o começo, mas o agente também ajudará você a lançar o produto iterado, aprimorado e robusto, pronto para produção.
O futuro próximo para nós, camponeses da programação.
Nesta mesma época do ano passado, tínhamos o Opus 4.1 e o GPT-5. Agora você pode comprar inteligência melhor por uma fração do preço. Recebemos o Opus 4.5 e o GPT 5.2 no final de novembro e início de dezembro do ano passado. Esses são os dois modelos que fizeram todos os CTOs entrarem em pânico durante as férias de inverno, pensando em como seria possível criar recursos e software à vontade.
Prevejo que teremos mais um ou dois grandes lançamentos da OpenAI e da Anthropic este ano. Meu palpite é que receberemos Astra da OpenAI em algum momento de setembro, e será um jogo do nível de Mythos/Fable, provavelmente mais poderoso que Fable 5.
Prevejo que os equivalentes de Fable e Astra ao lançamento do Opus 4.5 e do GPT 5.2 ocorrerão até o final deste ano ou no início do próximo.
Esse nível de inteligência e capacidade do modelo permitirá criar qualquer funcionalidade que você imaginar para o seu software. E funcionará. Além disso, poderá testá-la e verificá-la para você. Fará isso tão rápido quanto você estiver disposto a receber o código. A única questão será: o que você quer lançar? E o que você quer dar suporte?
Até o final do próximo ano, esse nível de inteligência artificial será barato o suficiente para que a maioria de nós possa trabalhar com ela em tempo integral, assim como Jarred pôde trabalhar com a versão pré-lançamento do Fable para produzir o Bun 1.4.
Em um ou dois anos, teremos amplo acesso a sistemas capazes de produzir tokens de 10 a 100 vezes mais rápido, a uma fração do custo. Veja o anúncio do Cerebras C4 e os resultados do OpenAI Jalapeño . Um acesso mais amplo e barato à inteligência de ponta em velocidades incríveis está a caminho.
É provável que a inércia organizacional signifique que teremos mais uma década de humanos escrevendo código manualmente e tendo cada linha revisada por seus colegas. Muitas empresas, senão a maioria, continuarão a desenvolver software da mesma forma que antes.
Mas os criadores de software mais produtivos farão isso sem programar no sentido tradicional. Eles estarão direcionando IAs, criando estruturas de controle, fábricas de software e sistemas de controle de qualidade e verificação que entregarão software funcional mais rápido do que jamais vimos.
E chegaremos ao ponto em que teremos mais software em produção, escrito por IA, do que escrito por humanos. Será o fim da programação.
I build databases. Founder and CTO at InfluxData, creator of InfluxDB.