Divulgação: A Bun foi adquirida pela Anthropic em dezembro de 2025. Eu e outros membros da equipe da Bun trabalhamos na Anthropic. Usei uma versão pré-lançamento do Claude Fable 5 para grande parte da reescrita em Rust.
Bun começou como uma adaptação linha por linha do transpilador de JavaScript e TypeScript do esbuild, de Go para Zig. Escrevi minha primeira linha de Zig em 16 de abril de 2021. Apostei no Zig depois de ver a página única de Referência da Linguagem Zig no Hacker News e ficar realmente empolgado com o controle de baixo nível e a preocupação com o desempenho.
Desde o início, o alcance de Bun era enorme:
- Transpilador, minificador e agrupador de JavaScript, TypeScript e CSS.
- gerenciador de pacotes compatível com npm
- Corredor de testes tipo Jest
- Resolução de módulos compatíveis com Node.js e TypeScript
- Cliente HTTP/1.1 e WebSocket
- Implementações de APIs do Node.js, como
fs`get`,net`get`tls, `get` e dezenas de outros módulos.
A versão inicial do Bun foi escrita por mim em um ano, em um apartamento apertado em Oakland, antes do mestrado em direito, usando o Zig. O resultado padrão para projetos ambiciosos como o Bun é acabar no cemitério de projetos paralelos abandonados em uma página de perfil do GitHub. O Zig tornou o Bun possível. Eu jamais teria conseguido construir tanto em um ano sem ele.
Atualmente, a CLI do Bun recebe mais de 22 milhões de downloads mensais. Ferramentas populares como Claude Code e OpenCode apostam no Bun como seu ambiente de execução. Vercel, Railway, DigitalOcean e outras empresas oferecem suporte nativo ao Bun.
O escopo do Bun também representou um desafio para a estabilidade. Aqui está uma pequena amostra dos bugs que corrigimos no Bun v1.3.14:
- Ocorre uma falha de uso de heap após liberação
node:zlibao chamar.reset()um fluxo zlib, Brotli ou Zstd enquanto uma operação assíncrona.write()ainda está em andamento no pool de threads. - Ocorre uma falha de uso após liberação (use-after-free)
node:zlibquando umonerrorretorno de chamada emite um sinal reentrantewrite()seguido porclose()um sinal em identificadores nativos. - O recurso `use-after-free` falha
node:http2quando funções de retorno de chamada JS reentrantes (por exemplo,session.request()dentro de um ouvinte de tempo limite, um getter de opções ou uma função de retorno de chamada de escrita) acionam um rehash do mapa de hash, invalidando os ponteiros de fluxo internos. UDPSocket.send()O uso após liberação (use-after-free)sendMany()em código de usuáriovalueOf()outoString()callbacks pode desanexar um intervaloArrayBufferentre a captura da carga útil e o envio propriamente dito.Buffer#copyfalha e leitura fora dos limitesBuffer#fillquando umvalueOfretorno de chamada desanexa ou redimensiona o objeto subjacenteArrayBufferdurante a coerção de argumentos- Ocorreu uma escrita fora dos limites do heap
UDPSocket.sendMany()quando o estado da conexão do socket mudou no meio da iteração por meio de callbacks JS do usuário. - Ocorreu um vazamento de memória no
crypto.scryptqual os buffers de retorno de chamada e de senha/salt protegidos nunca foram liberados quando a alocação do buffer de saída falhou. SSLWrapper.initvazou a senha digitada via strdup em caminhos de erro.- Vazamento de memória em
tlsSocket.setSession()que cada chamada vazava um caractereSSL_SESSION(~6,5 KB por chamada) devido à ausência de um caractereSSL_SESSION_freeapós o comando.d2i_SSL_SESSION - Vazamento de memória onde
fs.watch()os observadores nunca foram coletados pelo coletor de lixo após a execução.close(), causado por um estouro negativo na contagem de referências que fixou permanentemente cada observador como raiz do coletor de lixo. - Ocorreu uma falha no analisador CSS devido à dupla liberação de memória quando
background-cliphavia prefixos de fornecedor e planos de fundo com várias camadas. DuplexUpgradeContextnunca foi libertado — um vazamento completo portls.connect({ socket: duplex })- falha de condição de corrida em
MessageEventque o thread marcador GC poderia observar uma variante rasgadam_datadurante o acesso simultâneo de umBroadcastChannelouMessagePort
Poderíamos ter continuado corrigindo esses tipos de erros pontualmente para sempre, mas devemos aos nossos usuários, que contam conosco, fazer melhor do que isso e evitar sistematicamente que esses erros voltem a ocorrer.
O que já estávamos fazendo #
- Corrigimos o compilador Zig para adicionar suporte ao Address Sanitizer. Executamos nosso conjunto de testes com o ASAN a cada commit.
- Distribuímos versões ReleaseSafe verificadas quanto à segurança pelo Zig no Windows.
- Realizamos testes de fuzzing nas APIs de tempo de execução do Bun 24 horas por dia, 7 dias por semana, usando o Fuzzilli , o fuzzer do mecanismo JavaScript usado pelo V8 e pelo JavaScriptCore.
- Temos uma grande variedade de testes de vazamento de memória de ponta a ponta.
Isso é mais do que muitos projetos fazem.
Basta ser muito inteligente e não cometer erros? #
Nossa lista de correções de bugs estava enorme e eu estava cansado de ir dormir preocupado com travamentos no Bun. Não culpo o Zig por isso — outros usuários do Zig não têm os mesmos bugs que nós, e misturar coleta de lixo com gerenciamento manual de memória é algo incomum o suficiente para que nenhum software precise disso, a ponto de nenhuma linguagem ser projetada especificamente para essa necessidade. Não teríamos chegado tão longe sem o Zig, e serei eternamente grato. Até muito recentemente, a escolha da linguagem de programação era uma decisão definitiva para um projeto como o Bun.
JavaScript é uma linguagem com coleta de lixo e os mecanismos modernos de JavaScript, como o JavaScriptCore (e o V8), têm regras rígidas em relação ao tratamento de exceções e ao coletor de lixo. Zig, assim como C, não gerencia a memória para você, e essa é uma compensação que, para muitos projetos, é um ótimo motivo para usar Zig. Zig não possui construtores/destrutores, e espera-se que a maior parte da limpeza seja escrita explicitamente em cada ponto de chamada com ` defer.
Para o Bun, o gerenciamento correto do tempo de vida de valores coletados pelo coletor de lixo e de valores gerenciados manualmente tem sido uma das principais fontes de problemas de estabilidade — geralmente pequenos vazamentos de memória e, ocasionalmente, travamentos. Cada alocação de memória precisa ser meticulosamente revisada. Onde esses bytes são liberados? Como garantimos que sejam liberados apenas uma vez? Verificamos corretamente as exceções do JavaScript? Este ponteiro coletado pelo coletor de lixo está visível para o analisador de pilha conservador? Esta memória é coletada pelo coletor de lixo ou gerenciada manualmente?
Para problemas de estabilidade, quanto antes, melhor. O fuzzing ocorre após a mesclagem do código. A integração contínua (CI) acontece quando o código é enviado para o servidor (push). As verificações de segurança em tempo de execução e a higienização de endereços ocorrem quando o código é executado (idealmente em desenvolvimento, antes da CI).
Uma maneira comum de reduzir esse tipo de problema é garantir que o código de limpeza seja sempre executado exatamente uma vez para o código que precisa dele. O Zig foi projetado para ser uma linguagem simples, sem fluxo de controle oculto, e, portanto, prefere a deferpalavra-chave explícita para executar código no final de um escopo em vez do ~Destructor implícito do C++ ou do implicit do Rust Drop.
| Linguagem | Limpar |
|---|---|
| Zig | defer,errdefer |
| C++ | ~Destruidor, &&Mover |
| Rust | Derrubar |
Para o código Zig, quando exatamente devemos executar o código de limpeza? Se estivermos passando a mesma memória *Tpara várias funções diferentes, como saber quando ela não está mais acessível e pode ser liberada? Como funciona quando algumas funções precisam continuar referenciando a memória após serem chamadas? Nossa abordagem atual é uma mistura de:
- Os tempos de vida da arena, onde o escopo de quando ela é acessível é claro (o estado do analisador sintático não escapa da função que a chama e, portanto, os nós da AST são uma boa escolha nesse caso).
- contagem de referência
- Preste muita atenção.
Muitos projetos optam por responder a esse tipo de pergunta por meio de um guia de estilo. O TigerStyle do TigerBeetle é um exemplo em Zig, e o guia de estilo C++ do Google, com 31.000 palavras , é outro. O desafio com os guias de estilo é a sua aplicação. Como garantir que o guia de estilo seja seguido? Historicamente, a revisão de código era a resposta, com a aplicação da melhor maneira possível por meio de linters e analisadores estáticos.
Ter um guia de estilo rígido com expectativas de propriedade claramente definidas no sistema de tipos era uma opção viável para o Bun. Como o Zig não possui sobrecarga de operadores, provavelmente acabaríamos com muito código parecido com isto:
fn foo(a_ptr: SharedPtr(TCPSocket)) !void {
  const a: *TCPSocket = a_ptr.get();
  defer a_ptr.deref();

  const b = try do_something_with_a(a);
  defer b.deref();

  // ...
}
Isso é menos ergonômico do que o Zig que esperávamos:
fn foo(a: *TCPSocket) !void {
  const b = try do_something_with_a(a);
  // ...
}
E quanto a C/C++? #
Aproximadamente 20% do código do Bun é escrito em C++ e o Bun incorpora diversas bibliotecas C/C++:
- JavaScriptCore, o mecanismo JavaScript que alimenta o Safari
- uWebSockets e usockets – nosso servidor HTTP/WebSocket e loop de eventos.
- lshpack e lsquic –
HPACKe bibliotecas HTTP/3 - BoringSSL, uma bifurcação do OpenSSL do Google
- SQLite
C++ em vez de Zig seria uma escolha razoável para o Bun. Teríamos construtores e destrutores. Poderíamos eliminar muito extern "C"código de encapsulamento.
Mas ainda dependeríamos de guias de estilo aplicados por meio de revisão de código e, mesmo com o ASAN, a corrupção e os vazamentos de memória ainda ocorreriam.
Por que a Rust? #
Uma grande porcentagem dos bugs dessa lista são de uso após liberação (use-after-free), liberação dupla (double-free) e “esquecimento de liberar” em um caminho de erro. Em Rust seguro, esses são erros de compilação e a limpeza automática, semelhante ao RAII, é feita com ` Drop. Os erros de compilação são um ciclo de feedback melhor do que um guia de estilo.
Historicamente, reescrever o código é uma péssima ideia. Excluindo os comentários, o Bun tem 535.496 linhas de código Zig. Uma reescrita em outra linguagem levaria um ano inteiro para uma pequena equipe de engenheiros. Isso significaria congelar correções de bugs, correções de segurança ou desenvolvimento de novos recursos durante esse período. A abordagem menos arriscada para obter algo pronto para lançamento seria uma migração mecânica do Zig para o Rust, com o mínimo de alterações de comportamento, usando exatamente o mesmo conjunto de testes que já utilizamos para testar o Bun.
Felizmente, o próprio conjunto de testes do Bun é escrito em TypeScript, o que significa que não depende da linguagem de programação do ambiente de execução.
Um ano sem nenhum impacto para o usuário não era uma opção realista que pudéssemos considerar. Portanto, a aplicação de mudanças no estilo do código para corrigir problemas de estabilidade foi nossa melhor aposta, e era esse o nosso plano quando adicionamos ponteiros inteligentes inspirados em Rust à base de código do Bun.
Mas, honestamente, eu não queria fazer isso. Os ponteiros inteligentes caseiros oferecem uma ergonomia pior do que a do Rust, sem nenhuma das garantias.
E se, em vez disso, eu passasse uma semana testando se o novo modelo da Anthropic consegue reescrever o Bun em Rust?
A princípio, não esperava que funcionasse. Depois de alguns dias, uma alta porcentagem do conjunto de testes começou a passar e percebi o quanto o novo código Rust coincidia com o código-fonte original do Zig. Minha opinião mudou de “vale a pena tentar” para “vou incorporar isso”.
Claude, reescreva Bun em Rust. #
Existem muitas maneiras de fazer um trabalho péssimo nisso. Por exemplo, pedir para o Claude “Reescrever Bun em Rust. Sem cometer erros.” e depois rezar para que desse certo não foi o que eu fiz.
Pense em como uma pessoa faria isso. A primeira grande questão é:
Reescrita incremental? Ou tudo de uma vez?
Na minha experiência portando o transpilador do esbuild de Go para Zig para a versão inicial do Bun (sem LLMs), fazer tudo de uma vez é melhor. Uma reescrita incremental adiciona código temporário que você espera que seja excluído eventualmente, e seria problemática a curto e médio prazo.
A segunda grande questão: como?
Como manter o Bun em Rust sendo o mesmo Bun de antes, com a mesma arquitetura, desempenho e conjunto de recursos, ao mesmo tempo em que aproveitamos os recursos da linguagem Rust, como o verificador de empréstimos? Como garantir que a equipe ainda consiga mantê-lo após a reescrita?
Faça a reescrita que pareça que transpilamos nosso código Zig para Rust. Podemos refatorá-lo gradualmente para reduzir unsafeo uso e torná-lo mais parecido com o Rust idiomático após o lançamento do Bun v1.4.
Essas são as duas únicas questões importantes. Todo o resto é tática.
Loops que escrevem e revisam código #
Muitas das tarefas diárias de engenharia de software podem ser simplificadas em excesso, reduzindo-as a ciclos repetitivos.
// Pseudocode, not real code:
let task;
while ((task = todoList.pop())) {
  const result = task();
  const feedback = await Promise.all([review(result), review(result)]);
  await apply(feedback, result);
}
A tasktem algum contexto associado a ele (um ticket do Jira, um problema do GitHub, etc.). Este resulté o código que você escreveu para corrigir o problema. O(s) revisor(es) de código reviewanalisam as alterações para verificar regressões e a correção. E então você responde ao feedback.
Reescrevi o Bun em Rust usando cerca de 50 fluxos de trabalho dinâmicos no Claude Code, executados continuamente ao longo de 11 dias.
Cada fluxo de trabalho dinâmico era um loop como este – um fluxo de trabalho para:
- Gere um guia de portabilidade mapeando padrões e tipos Zig para padrões e tipos Rust.
- Converta mecanicamente cada
.zigarquivo para um.rsarquivo correspondente, seguindo as diretrizes de PORTING.md e LIFETIMES.tsv. - Corrija os erros de compilação de todos os crates.
- Faça com que subcomandos como
bun test`or`bun buildfuncionem. - Faça todos os testes do pacote completo de testes da Bun para ser aprovado.
- Diversas refatorações e limpezas de grande porte.
Durante a maior parte desses 11 dias (e depois), monitorei os fluxos de trabalho – lendo manualmente as saídas para verificar problemas e erros, e solicitando a Claude que editasse o loop para corrigir as coisas.
Como você revisa um PR com mais de 1 milhão de linhas adicionadas? Como você começa a construir a confiança necessária para mesclar de forma responsável grandes quantidades de código escrito por alunos de mestrado em direito?
Um conjunto de testes independente de linguagem com um milhão de asserções, revisão de código adversária e, quando algo dá errado, correção do processo que gera o código em vez de correção manual do código.
Revisão adversarial #
A análise adversarial pede a Claude (em uma janela de contexto separada) que apresente exaustivamente as razões pelas quais as alterações criam erros ou não funcionam.
Janelas de contexto divididas
Normalmente, quando se trata de humanos, a pessoa que revisa o código não é a mesma que o escreveu. Quem escreve o código quer que ele seja integrado ao software, o que pode influenciar suas ações e levá-lo a lançar a versão antes que esteja pronta.
Claude é igual. O Claude que escreveu o código quer que ele seja aceito. O Claude que revisa quer encontrar problemas no código.
1 implementador, 2 ou mais revisores adversários por implementador. A única função do revisor é encontrar erros e as razões pelas quais o código não funciona. O implementador não revisa. O revisor não implementa.
✻ Claude Code · Fluxo de trabalho dinâmicorevisão adversarial3 dos muitos bugs detectados pela revisão adversária antes da fusão
Erro 1 de 3 · fechamento assíncrono▶ next bug · the negative timestamp
✻ClaudeimplementadorSeu contexto: o original .zig, o plano portuário, seu próprio raciocínio.
✻Clauderevisor adversárioSeu contexto: apenas a diferença. Foi dito para assumir que o código está errado.
✻src/runtime/api/bun/js_bun_spawn_bindings.rs
· compila sem erros
para stdio em [spawned_stdout, spawned_stderr] {
combinar stdio {
StdioResult :: Buffer ( mut pipe) => {
// pipe: Box<uv::Pipe> — passe para a libuv para fechar
pipe.close ( Subprocess :: on_pipe_close )
}
StdioResult :: Fd (fd) => fd . close (),
StdioResult :: Não disponível => {}
}
}
✻`uv_close` é assíncrono: a libuv mantém o ponteiro de identificador bruto até o próximo ciclo do loop, então chama `on_pipe_close`, que libera a alocação. Mas `pipe` é uma Box que é descartada ao final deste braço de correspondência — a libuv fica com a memória liberada, e o callback de fechamento a libera uma segunda vez. Uso após liberação, seguido de dupla liberação.
✻
Caixa :: vazamento (tubo) . fechar ( Subprocesso :: on_pipe_close)f0a454376c7 · win-review: js_bun_spawn_bindings.rs vaza Box<uv::Pipe> antes de async uv_close para evitar UAF/liberação dupla em on_pipe_closeTrês bugs que os revisores adversários de fato detectaram — cada commit citado traz a atribuição da revisão na linha de assunto. Todos os três compilaram; todos os três pareceram plausíveis. O revisor é um segundo Claude em sua própria janela de contexto: ele recebe o diff e nada mais — nenhum dos raciocínios do implementador — e é instruído a encontrar o erro. O código é condensado a partir dos commits citados; mesmos bugs, mesmas correções.
Como é isso? #
Se você está prestes a fazer algo grande e caro, economizar tempo e dinheiro minimizando os riscos primeiro.
Trabalho preparatório #
Antes de escrever qualquer código, passei cerca de 3 horas conversando com Claude sobre como mapear padrões do nosso código-fonte Zig para Rust. Claude transformou essa discussão em um PORTING.mddocumento, que acabou sendo publicado no Hacker News .
A próxima pergunta é: como adicionar tempos de vida (timeouts) em Rust a um código que gerencia memória manualmente?
Foi aí que eu sugeri a Claude algo mais ou menos assim:
Eu: Vamos iniciar um fluxo de trabalho dinâmico para analisar os tempos de vida adequados de cada campo de struct no código-fonte. Este fluxo de trabalho deve ler cada campo de struct em cada arquivo e rastrear o fluxo de controle. Primeiro, procure por campos de struct com tempos de vida complexos para expressar em Rust, depois proponha um tempo de vida para esse campo, em seguida, use 2 agentes de revisão adversários para revisar esse tempo de vida, aplique qualquer feedback e serialize em um arquivo LIFETIMES.tsv para que outros agentes possam analisar.
Em seguida, realizamos uma rodada de revisões comparativas PORTING.mdpara LIFETIMES.tsvcorrigir quaisquer sugestões conflitantes e verificar tudo minuciosamente. Também fiz uma leitura manual.
Teste piloto #
Antes de pedir a Claude para traduzir todos os 1.448 arquivos .zig para arquivos .rs, comecei com apenas 3. Para cada um dos 3 arquivos, 1 implementador escreveu o novo .rsarquivo, 2 revisores independentes verificaram se o .rsarquivo correspondia ao comportamento do .zigarquivo original e se seguia o padrão PORTING.md& LIFETIMES.tsv. Depois disso, 1 pessoa responsável pelas correções aplicou quaisquer sugestões.
Falsos começos #
Pedi ao Claude para executar o fluxo de trabalho em todos os 1.448 arquivos .zig e, cerca de 2 minutos depois, um Claude executou o comando git stashantes de confirmar a alteração. Outro executou o comando novamente git stash pop. E depois o git reset HEAD --hardoutro. Eles estavam interferindo um no outro! E se eu colocasse cada Claude em uma árvore de trabalho separada, ficaria sem espaço em disco, porque o repositório git do Bun é muito grande e, eventualmente, as alterações precisarão ser compiladas e visualizadas juntas.
Então, pedi ao Claude para editar o fluxo de trabalho para instruí-lo a nunca executar git stashnenhum git resetcomando gitque não confirme um arquivo específico de uma só vez. cargoNenhum comando lento.
Então, Claude retomou os fluxos de trabalho. E estava funcionando! Muito lentamente, então eu o dividi em apenas 4 fragmentos de fluxo de trabalho, cada um com sua própria árvore de trabalho (4 árvores de trabalho no total), cada um executando 16 instâncias do Claude, realizando commits e pushes de arquivos.
Finalmente escrevendo o código #
Graças a toda a paralelização e a esse trabalho preparatório, no auge, Claude escreveu cerca de 1.300 linhas de código por minuto. Cada linha de código foi revisada por dois revisores adversários diferentes (também Claude) e passou por uma rodada de correções antes de ser confirmada. Absolutamente nada funcionou ainda.
11 dias × 24 horas · PDT6.502 confirmações
1695 commits/hora12am6am12pm6pmMay 4May 5May 6May 7May 8May 9May 10May 11May 12May 13May 14Cada commit no branch da porta (excluindo merges), agrupado por hora. Hora de pico: 695 commits.
Percebeu a inconsistência no tempo? Esqueci de aumentar o IOPS padrão na instância EC2 onde o teste foi executado. Um único grepcomando lento foi suficiente para congelar as operações de leitura e gravação no disco por vários minutos.
Erros de compilação como uma fila de trabalho #
Depois de escrever todo o código, pedi ao Claude para criar um fluxo de trabalho que corrigisse todos os erros de compilação. Fomos corrigindo pacote por pacote.
✻ Claude Code · Fluxo de trabalho dinâmico
≈15,672erros deixados↻ repetir
Wed, May 6, 1:09 AM PDT
erros.txt33 fix commits
· phase-d(glob): DirEntryNameWrapper.value -> *const [u8] (drop fabricated ‘static via from_Como funcionou a fase D, reproduzido a partir de seus 1.610 commits reais (6 de maio, PDT): o comando `cargo check` registrou aproximadamente 16.000 erros em um arquivo, agrupados por crate; o fluxo de trabalho os dividiu entre 64 Claudes — 16 loops em 4 árvores de trabalho, cada Claude corrigindo, dois revisando e um aplicando. Cada chip representa um lote de commits reais: ele é alocado ao seu crate específico e somente então os contadores são atualizados. As linhas de erro são commits reais.
A classe de erro mais complexa era a de dependências cíclicas.
Nosso código-fonte Zig era uma única unidade de compilação (efetivamente um único crate). Eu queria dividir o novo código-fonte Rust em cerca de 100 crates para que o Rust compilasse mais rápido, mas isso exigia evitar dependências cíclicas e minimizar as mudanças em comparação com a implementação original do Zig. Meu PR para fazer isso imediatamente antes de começar a reescrita do Rust foi insuficiente. Em vez de começar do zero, executei outro fluxo de trabalho para classificar onde o código com dependências cíclicas deveria ser alocado e documentar tudo — e então outro fluxo de trabalho para realizar a refatoração.
A correção das dependências cíclicas revelou cerca de 16.000 erros de compilação. Um número enorme para um único humano, mas não tão absurdo para 64 Claudes trabalhando simultaneamente.
Para maximizar o paralelismo, o fluxo de trabalho percorria cada caixa.
- Para cada crate, execute o comando
cargo check, agrupe a saída por arquivo e salve os erros em um arquivo. - Corrija todos os erros de compilação dentro desse crate.
- 2 revisores adversários para as alterações do crate
- 1 técnico aplica as correções
Para evitar que os Claudes se atrapalhem, cargo checka corrida começou apenas no início e, assim como nas outras corridas, não continuou gitaté o final.
Mais um começo falso
Claude interpretou “vamos compilar todas as crates” como “criar stubs para as funções com erros de compilação”. Claude também começou a adicionar comentários explicativos suspeitamente longos para documentar soluções alternativas, então adicionei esta regra para que os revisores adversários rejeitassem:
Se você precisa de um parágrafo inteiro de comentários para justificar por que a solução alternativa é aceitável, o código está errado — corrija o código.
Após uma breve edição e algumas horas, esses problemas pararam de acontecer.
Testes de fumaça #
As modelos adoram dizer “testes de fumaça”.
Uma vez cargo checkaprovado, o próximo passo era compilá-lo e executá-lo bun --version. Apresentava erros de vinculação. Em seguida, entrava em pânico imediatamente ao iniciar.
O próximo objetivo era fazê-lo funcionar bun test <file>. Assim que isso funcionasse, poderíamos começar a executar os testes! Hora de outro fluxo de trabalho, percorrendo os subcomandos da CLI do bun:
- Salve cada rastreamento de pilha com falha em um arquivo, juntamente com seu subcomando.
- Para cada stacktrace com falha agrupado por subcomando, aplique 1 correção Claude.
- 2 revisores adversários
- 1 técnico aplica as sugestões
Faça com que o conjunto de testes seja aprovado localmente #
Este fluxo de trabalho era executado em loop nos arquivos de teste.
Execute cerca de 100 arquivos de teste aleatórios, distribuídos em quatro diretórios de trabalho por pasta no código-fonte. Para cada teste com falha, salve o rastreamento de pilha e os erros em um arquivo. Um dos implementadores propõe uma correção, dois revisores adversários a avaliam e, por fim, um dos responsáveis pela correção a aplica.
Mais começos em falso
Nosso conjunto de testes possui muitos testes de vazamento de memória e alguns testes de integração que podem levar mais de um minuto — por exemplo, um teste que next devverifica a recarga dinâmica de módulos pode detectar alterações até 100 vezes. Vários desses testes atingem o tempo limite em builds de depuração.
Também temos testes de estresse que esgotam o número máximo de sockets TCP na máquina, testes que leem e gravam gigabytes em disco e testes que geram cerca de 10 mil processos.
Isso exigia um isolamento mais robusto do que “por favor”, então usamos systemd-run(cgroups) para limitar o uso de memória e CPU e isolar os namespaces de PID. Mesmo assim, a máquina ficou sem espaço em disco e travou diversas vezes.
Faça com que o conjunto de testes passe na CI #
Dois dias após a primeira execução da integração contínua, a lista de arquivos com falha caiu de 972 para 23. Um dia e meio depois, o Linux passou a funcionar perfeitamente — e, pela primeira vez, parecia que essa reescrita em Rust realmente daria certo.
✻ Claude Code · Fluxo de trabalho dinâmico Buildkite · A corrida para o verde, por plataformaO Windows terminou por último · 11 de maio, 6h23 PDT
6 / 6 plataformas verdes↻ replay
build #54202 · Thu, May 14, 12:23 AM PDTMay 8May 9May 10May 11May 12May 13May 14
macOS x64 · 2 fragmentos ✓
Linux arm64 · 60 shards ✓
Linux x64 · 60 shards ✓
macOS arm64 · 4 fragmentos ✓
Windows x64 · 8 fragmentos ✓
Windows arm64 · 8 fragmentos
✓✓ Todas as 6 plataformas estão funcionando corretamente · versão #54202 → integradaCada conjunto de testes (shards) de uma compilação de CI, por plataforma, em 135 compilações que executaram testes (420 extraídas do BuildKite). Verde claro: todos os shards foram aprovados. Verde escuro: nenhum teste falhou, mas a execução foi interrompida (substituída). Vermelho: pelo menos um shard falhou. Cada faixa é marcada quando seu conjunto completo de testes é aprovado pela primeira vez — os 60 shards do Linux ficaram verdes quase um dia inteiro antes do Windows. As plataformas continuaram oscilando em vermelho até que o último teste com falha fosse concluído; a compilação final totalmente verde foi a de número 54202.
O restante do período que antecedeu a fusão transcorreu sem problemas. Um fluxo de trabalho que se repetia para corrigir falhas nos testes de integração contínua (CI) para cada plataforma até que não houvesse mais falhas. Vários fluxos de trabalho foram utilizados para limpeza relacionada ao Windows, para remover código duplicado, reduzir o uso inseguro e, de modo geral, para limpar o código.
Integrando a reescrita do Rust #
Assim que 100% do conjunto de testes do Bun passou na integração contínua em todas as plataformas (e eu verifiquei manualmente se os testes estavam de fato sendo executados e não ignorados), executei uma série de comandos localmente para testar tudo – e então cliquei no botão de mesclagem.
A fusão mainnão é um lançamento versionado. Nesse ponto, eu estava confiante o suficiente para prosseguir e me comprometer com a reescrita, mas ainda não confiante o suficiente para lançá-la.
Estatísticas #
No pico da demanda, estávamos executando 4 desses fluxos de trabalho simultaneamente, cada um em uma árvore de trabalho separada, com 16 Claudes por fluxo de trabalho. Cerca de 64 Claudes por vez.
git log · claude/phase-a-portpico: 58 confirmações em um minuto0compromissos+0Linhas escritas, reescritas incluídas↻ replay
Segunda-feira, 4 de maio, 7h05 (horário do Pacífico)first 100-file draft batchPR #30412 openedmergedTodos os 6.502 commits (excluindo merges) foram reproduzidos. As barras
rosas representam principalmente código novo; as barras
ciano representam principalmente remoções. O contador de linhas contabiliza cada reescrita ao longo do processo — a diferença final foi de +1.009.272. O log contém as mensagens reais dos commits.
0 testes ignorados ou excluídos
11 dias (3 de maio → mesclado em 14 de maio) · 6.778 commits
| Plataforma | expect() chama | Testes | Arquivos |
|---|---|---|---|
| Debian 13 x64 | 1.386.826 | 60.624 | 4.174 |
| macOS 14 arm64 | 1.259.953 | 58.850 | 4.175 |
| Windows 2019 x64 | 1.007.544 | 57.337 | 4.173 |
Antes da fusão, isso exigia 5,9 bilhões de tokens de entrada não armazenados em cache, 690 milhões de tokens de saída e 72 bilhões de leituras de tokens de entrada armazenados em cache — cerca de US$ 165.000, considerando o preço da API. Se fosse feito manualmente, acredito que levaria cerca de um ano para três engenheiros com pleno conhecimento do código-fonte, período durante o qual não conseguiríamos melhorar a compatibilidade com Node.js, corrigir bugs, solucionar problemas de segurança ou implementar novos recursos. Nunca teríamos conseguido. A alternativa realista era não fazer nada e continuar corrigindo os bugs mencionados no início deste post indefinidamente.
Esta é a vanguarda do que é possível hoje. Usei uma versão pré-lançamento do Claude Fable 5 , um modelo da classe Mythos. Os fluxos de trabalho dinâmicos do Claude Code mantiveram 64 instâncias do Claude em execução por 11 dias (eu teria que ter desenvolvido minha própria estrutura para conseguir isso de outra forma).
O trabalho continua #
Desde a integração da versão Rust, concluímos 11 rodadas de revisão de segurança da Claude Code Security e implementamos as soluções apontadas.
Também adicionamos fuzzing guiado por cobertura 24 horas por dia, 7 dias por semana, para todos os analisadores sintáticos do Bun — JavaScript, TypeScript, JSX, CSS, JSON5, JSONC, TOML, YAML, Markdown, INI, scripts do Bun Shell, intervalos de versionamento semântico, arquivos .patch e cores CSS. O fuzzer envia automaticamente os bugs encontrados para o Claude, que solicita a reprodução e correção do problema, e revisamos os PRs com a ajuda de humanos. Até o momento, ele executou nossos analisadores sintáticos 100 bilhões de vezes, o que resultou em cerca de 15 PRs.
No momento em que este texto foi escrito, cerca de 4% do código Rust do Bun está dentro de um unsafebloco (aproximadamente 13.000 unsafepalavras-chave em cerca de 27.000 linhas / 780.000 linhas no total), e 78% desses blocos consistem em uma única linha — um ponteiro proveniente de C++ ou uma chamada a uma biblioteca C. Espero que esse número diminua com o tempo, à medida que refatoramos de uma adaptação fiel do Zig (que não possuía unsafepalavras-chave que pudessem ser buscadas com grep) para um Rust idiomático, mas continuaremos usando bibliotecas C e C++, como o JavaScriptCore, para que ele sempre tenha mais unsafedo que apenas projetos em Rust puro.
Erros de portabilidade #
O foco da reescrita do Rust é a estabilidade, mas seria impossível implementar uma mudança tão drástica sem introduzir nenhuma regressão.
Essa reescrita introduziu 19 regressões conhecidas, todas já corrigidas.
A maioria das regressões ocorreu em códigos que são sintaticamente idênticos em ambas as linguagens, mas semanticamente diferentes.
Efeito colateral internodebug_assert!
Esses dois trechos de código parecem semelhantes, mas se comportam de maneira diferente. O código do Zig asserté uma função, portanto seu argumento é executado em todas as compilações. O código do Rust debug_assert!é uma macro, então, em compilações de lançamento, toda a expressão é apagada, incluindo a insert_stalechamada.
// Zig:
if (dev.framework.react_fast_refresh) |rfr| {
    assert(try dev.client_graph.insertStale(rfr.import_source, false) == IncrementalGraph(.client).react_refresh_index);
}

// Rust:
if let Some(rfr) = &dev.framework.react_fast_refresh {
    debug_assert!(dev.client_graph.insert_stale(&rfr.import_source, false)? == react_refresh_index);
}insert_staleAdiciona um arquivo ao grafo de recarregamento a quente do servidor de desenvolvimento frontend. Em versões de produção, parou de funcionar e o recarregamento a quente apresentou problemas em certos casos para projetos com rotas HTML que usam React, enquanto um arquivo recarregado a quente é invalidado. Cannot destructure property 'isLikelyComponentType' of 'k'Versões de depuração funcionaram. #30678
Fatias de comprimento irregular
O auxiliar Zig do Bun reinterpretSlice(u16, bytes)(anterior aos casts internos que suportam slices) usava @divTrunce ignorava um byte ímpar final. bytemuck::cast_sliceEm vez disso, entrava em pânico ao detectar um byte ímpar Blob.text(). Ao detectar uma marca de ordem de bytes UTF-16 seguida por um número ímpar de bytes, o processo parava de retornar uma string e entrava em pânico. Voltamos a ignorar o byte ímpar: &buf[..buf.len() & !1]. #31188
Verificações de limites
No macOS e no Linux, compilamos o código Zig do Bun com `–no- ReleaseFastlimits-check`, o que remove as verificações de limites. As versões de lançamento do Rust mantêm essas verificações.
O resolvedor de módulos do Bun armazena nomes de arquivos longos em uma lista global que, por sua vez, ocupa os blocos de estouro. O código Zig original dimensionava cada bloco em count / 4, ou 2048. A adaptação deixou um espaço reservado:
/// ... so use a nonzero stand-in until Phase B threads the
/// per-instantiation value through.
pub const BSS_OVERFLOW_BLOCK_SIZE: usize = 64;
Isso reduziu o limite de 8,4 milhões de nomes de arquivos internados para 270.272, que é o limite atingido por projetos reais, e tornou ptrs[4095]viável uma margem de erro de um nível que portamos do Zig. O Rust entrou em pânico em vez de escrever além do limite. O Zig também entraria em pânico nesse caso, se usássemos ReleaseSafe(só usamos no Windows). #31503
comptimestrings de formatação
Output.prettyReescreve <r>e <d>colore marcadores em sequências de escape ANSI. Em Zig, fmté comptime, então os marcadores desaparecem antes que os argumentos sejam substituídos. As funções em Rust não têm parâmetros de tempo de compilação, então Output::prettysó viam a string final e reescreviam os marcadores sobre os argumentos também.
// Zig:
pub inline fn pretty(comptime fmt: string, args: anytype) void;
Output.pretty("<r>{f}<r>", .{hyperlink});

// Rust:
pub fn pretty(payload: impl PrettyFmtInput);
Output::pretty(format_args!("<r>{}<r>", hyperlink));
bun update -iImprime os nomes dos pacotes como hiperlinks OSC 8 , terminados por ESC \. Essa barra invertida fica imediatamente antes do <do final <r>, o analisador de marcadores a ignora e rimprime como texto.
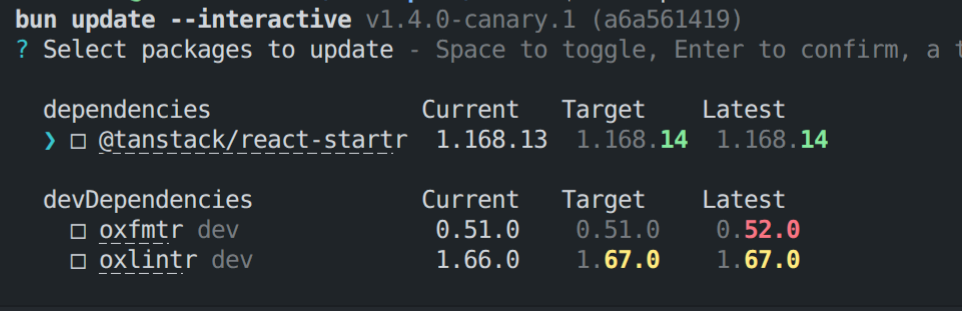
Deveria estar escrito oxfmt, e não oxfmtr.
Em Rust, precisa ser uma macro: bun_core::pretty!("<r>{}<r>", hyperlink). #30693
Bun é melhor em Rust #
Até o momento, o Bun v1.4.0 corrige 128 bugs que se reproduziam na v1.3.14. Esses bugs variam de vazamentos de memória a travamentos e textos de ajuda com cores incorretas.
Uso de memória reduzido #
Rust possui uma poderosa ferramenta de linguagem para limpar a memória: Drop`. Quando Dropimplementada, a dropfunção é chamada automaticamente sempre que o valor sai do escopo.
impl Drop for Bytes {
    fn drop(&mut self) {
        if !self.pinned.is_empty() {
            JSC__JSValue__unpinArrayBuffer(self.pinned);
        }
    }
}
Em Zig, deferpode ser usado para executar código no final de um escopo:
const bytes: ArrayBuffer = try .fromPinned(global, value);
defer bytes.unpin();
Em Zig, deferé necessário adicionar `cleanup` a cada chamada individual que possa precisar de limpeza. É fácil acabar esquecendo de limpar (um vazamento de memória) ou executar o código de limpeza duas vezes em trechos de código de tratamento de erros raramente acessados (uma liberação dupla de memória). Em Rust, ` Dropcleanup` é executado automaticamente quando o valor não está mais acessível — trocando a ausência de fluxo de controle oculto pela prevenção de uma armadilha comum.
DropCorrigidos diversos vazamentos de memória no Bun relacionados a caminhos de arquivos no código de tratamento de erros.
Corrigimos todos os vazamentos de memória instrumentáveis.
Aprimoramos a integração do LeakSanitizer do Bun para rastrear todas as alocações de memória do código nativo .
Eis um exemplo: cada Bun.build()chamada em processo vazava vários megabytes de memória — texto fonte analisado e tabelas de símbolos AST que sobreviviam à compilação à qual pertenciam.
// Bundle the same 60-module project 2,000 times in one process
for (let i = 0; i < 2_000; i++) {
  await Bun.build({
    entrypoints: ["./index.js"],
    minify: true,
    sourcemap: "external",
  });
}
Na versão 1.3.14 do Bun, cada compilação vazava cerca de 3 MB, indefinidamente — ferramentas como servidores de desenvolvimento que agrupavam recursos em cada requisição eventualmente ficavam sem memória. Na versão 1.4.0 do Bun, o consumo de memória se estabiliza:
| Construções | Bun v1.3.14 | Bun v1.4.0 |
|---|---|---|
| 500 | 1.914 MB | 526 MB |
| 1.000 | 3.506 MB | 586 MB |
| 1.500 | 5.097 MB | 608 MB |
| 2.000 | 6.745 MB | 609 MB |
Uma tentativa anterior de fazer isso no Zig não foi aceita porque a falta de um equivalente ao Drop tornava mais difícil ter confiança na fusão.
Tamanho binário menor #
As alterações iniciais na reescrita em Rust reduziram o tamanho do binário em 3,8 MB no Windows, 5,5 MB no macOS e 6,8 MB no Linux. Isso se deve principalmente ao uso excessivo de recursos comptime em nosso código Zig.
Após essa redução inicial, a equipe explorou mais oportunidades para reduzir o tamanho do binário usando otimizações do linker, como o Identical Code Folding, removendo dados não utilizados do ICU e descomprimindo pequenas partes da libicu de forma preguiçosa com um dicionário zstd sob demanda.
Combinando a reescrita em Rust, as alterações na ICU e a compactação de código idêntica, o tamanho do binário do Bun diminui em cerca de 20% no Linux e no Windows.
| Versão | Plataforma | Tamanho |
|---|---|---|
| Bun v1.4.0 (canário) | Windows | 76 MB |
| Bun v1.3.14 | Windows | 94 MB |
| Bun v1.4.0 (canário) | Linux | 70 MB |
| Bun v1.3.14 | Linux | 88 MB |
Redução do uso de espaço na pilha #
O analisador TOML e todos os outros analisadores recursivos descendentes do Bun (JSON, YAML, JavaScript, TypeScript e mais) agora usam menos espaço na pilha.
Isso causou algumas falhas nos testes antes da fusão da reescrita em Rust:
bun test v1.3.14-canary.1 (e99311e58)
.......

105 | });
106 |
107 | it("Bun.TOML.parse throws on deeply nested inline tables instead of crashing", () => {
108 |   const depth = 25_000;
109 |   const deepToml = "a = " + "{ b = ".repeat(depth) + "1" + " }".repeat(depth);
110 |   expect(() => Bun.TOML.parse(deepToml)).toThrow(RangeError);
                                               ^
error: expect(received).toThrow(expected)

Expected constructor: RangeError

Received function did not throw
Received value: {
  a: {
    b: {
      b: {
        b: {
          b: {
            b: {
              b: {
                b: {
                  b: [Object ...],
                },
              },
            },
          },
        },
      },
    },
  },
}

      at <anonymous> (/var/lib/buildkite-agent/build/test/js/bun/resolve/toml/toml.test.js:110:42)

✗ Bun.TOML.parse throws on deeply nested inline tables instead of crashing [2907.64ms]llvm.lifetime.startO gerador de código LLVM IR do Rust emite funções intrínsecas e do LLVM llvm.lifetime.endpara variáveis de pilha quando elas não estão mais em uso, o que permite que o LLVM reutilize espaços de pilha. Isso possibilita que funções grandes com escopos aninhados usem significativamente menos espaço de pilha.
Anteriormente, contornávamos manualmente um problema em aberto refatorando funções particularmente grandes em muitas funções menores.
2% a 5% mais rápido #
Rust suporta otimização em tempo de link entre linguagens como C/C++ e Rust, o que possibilita a inlining entre diferentes linguagens de programação (incrível, não é?!).
Comparamos o desempenho do Bun v1.3.14 com o do Bun v1.4.0 em um sistema Linux x64 (EC2, Xeon Platinum 8488C). A taxa de transferência HTTP foi medida com o oha em servidores hello-world, e as cargas de trabalho dos aplicativos foram medidas com o hyperfine .
Taxa de transferência HTTP (requisições/s, média de 3 rodadas)
| servidor | Bun v1.3.14 | Bun v1.4.0 | Δ |
|---|---|---|---|
| Bun.serve | 169,6 mil | 177,7 mil | +4,8% |
| nó:http | 103,8 mil | 108,5 mil | +4,5% |
| Elísia | 158,9 mil | 163,3 mil | +2,8% |
| expressar | 64,5 mil | 66,6 mil | +3,2% |
| agilizar | 91,5 mil | 95,9 mil | +4,8% |
Aplicativos / CLI (hyperfine)
| carga de trabalho | Bun v1.3.14 | Bun v1.4.0 | Δ |
|---|---|---|---|
| próxima construção | 13,62 s | 13,03 s | +4,5% |
| construção vite (tsc + vite) | 1,69 s | 1,65 s | +2,2% |
| tsc -b –forçar | 0,94 s | 0,89 s | +4,7% |
Produção #
A Prisma lançou a versão beta pública do Prisma Compute na reescrita em Rust de Bun.
“Enfrentamos vazamentos de memória e um pool de conexões que não conseguia se recuperar após uma máquina virtual ser pausada e retomada. Quando a reescrita em Rust surgiu, testamos contra os mesmos modos de falha. Ela lidou com eles perfeitamente.” – Alexey Orlenko
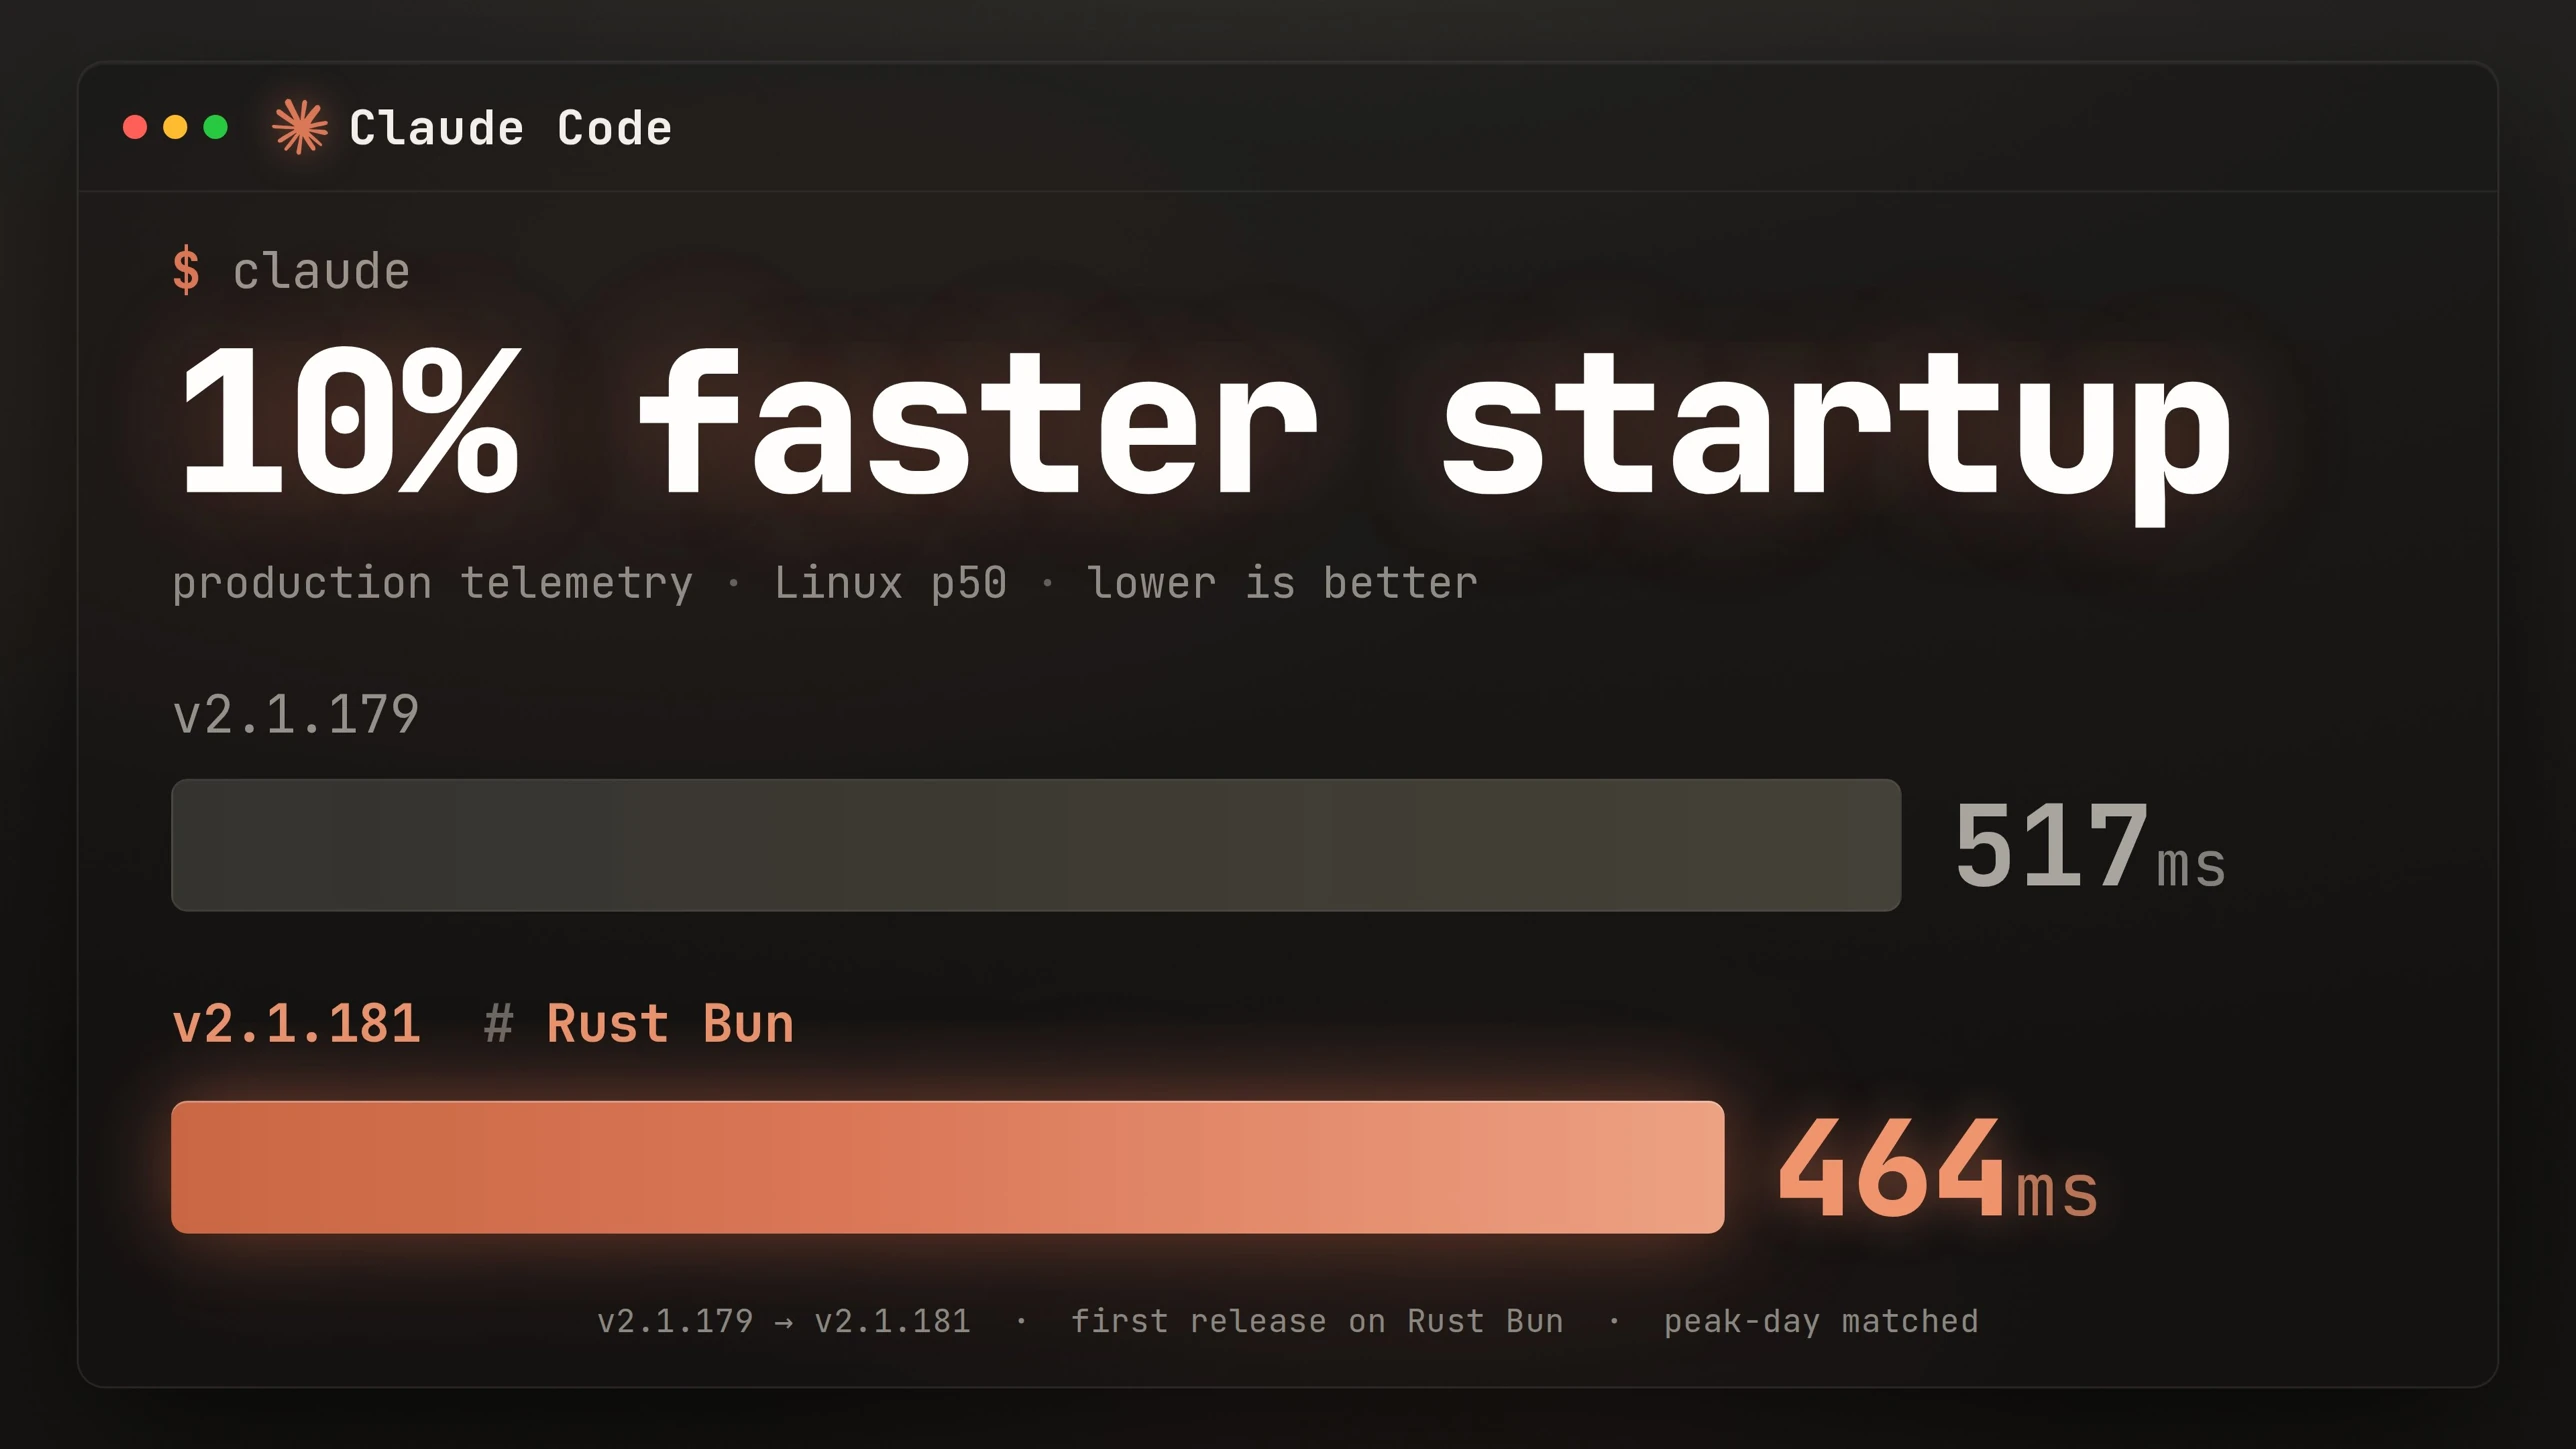
Claude Code v2.1.181 (lançado em 17 de junho) e versões posteriores usam a versão Rust do Bun. A inicialização ficou 10% mais rápida no Linux, mas, fora isso, quase ninguém notou diferença. O tédio é bom.
Envio #
A versão 1.3.14 do Bun foi a última versão escrita em Zig. A versão 1.4.0 será a primeira versão escrita em Rust. Ela já está disponível em versão canary. Por favor, reporte quaisquer problemas que encontrar.
bun upgrade --canaryManutenibilidade #
Para mim e para a equipe, nossa nova base de código Rust parece muito semelhante à antiga base de código Zig. Por exemplo, aqui está um trecho do código Zig original e do novo código Rust:
pub fn canMergeSymbols(
    scope: *Scope,
    existing: Symbol.Kind,
    new: Symbol.Kind,
    comptime is_typescript_enabled: bool,
) SymbolMergeResult {
    if (existing == .unbound) {
        return .replace_with_new;
    }

    if (comptime is_typescript_enabled) {
        // In TypeScript, imports are allowed to silently collide with symbols within
        // the module. Presumably this is because the imports may be type-only:
        //
        //   import {Foo} from 'bar'
        //   class Foo {}
        //
        if (existing == .import) {
            return .replace_with_new;
        }

        // ...
    }

    // ...
}
pub fn can_merge_symbol_kinds<const IS_TYPESCRIPT_ENABLED: bool>(
scope_kind: Kind,
existing: symbol::Kind,
new: symbol::Kind,
) -> SymbolMergeResult {
if existing == symbol::Kind::Unbound {
return SymbolMergeResult::ReplaceWithNew;
}
if IS_TYPESCRIPT_ENABLED {
// In TypeScript, imports are allowed to silently collide with symbols within
// the module. Presumably this is because the imports may be type-only:
//
// import {Foo} from 'bar'
// class Foo {}
//
if existing == symbol::Kind::Import {
return SymbolMergeResult::ReplaceWithNew;
}
// ...
}
// ...
}Qualquer pessoa que entenda o código Zig original entenderá o código Rust traduzido mecanicamente. Revisei o PR original da reescrita em Rust verificando se os agentes de revisão de código adversários estavam detectando corretamente as discrepâncias entre o código Zig e o código Rust, se estavam garantindo que o guia de portabilidade e o guia de ciclo de vida estavam sendo seguidos e também lendo manualmente grande parte do código lado a lado com as versões Zig e Rust.
O que vem a seguir ? #
A versão 1.4 do Bun torna o Bun mais rápido, menor, usa menos memória e fornece à equipe ferramentas incrivelmente poderosas para melhorar sistematicamente a estabilidade no futuro: o verificador de empréstimos do Rust, Miri (que é executado em uma parcela crescente do código em CI), LeakSanitizer e fuzzing guiado por cobertura 24 horas por dia, 7 dias por semana, para analisadores sintáticos. Ainda há mais para refatorar , mas as coisas começaram muito bem.
Essa reescrita em Rust teria levado um ano de trabalho de uma equipe de engenheiros com conhecimento completo do código-fonte. Com apenas um engenheiro usando o Fable e monitorando de perto o código do Claude, passamos do início ao fim, com 100% dos testes aprovados em todas as plataformas, em apenas 11 dias.
Um engenheiro consegue fazer muito mais hoje do que há um ano.